

13|检索增强:Agent 的知识库和证据链
黄佳
你好,我是黄佳。今天我们继续讲记忆模式组的第二个具体模式,检索增强,也就是大家更熟悉的 RAG。
上一讲分层保留,我们先给 Agent 的记忆建了一套货架。策略 / 管理层、项目 / 领域层、用户 / 租户层、任务 / 会话层、草稿纸 / 轮次层,各有各的位置,也各有各的命运。
货架搭好以后,下一件事就是“取”。在真实系统里,货架里最大的一层,往往是语义记忆。公司制度、产品条款、历史政策、FAQ、培训材料、合同模板、研发文档,体量动辄几千份文档、几十万个片段。这些东西不可能常驻上下文窗口,只能在需要时取回来。
这就是 RAG 要解决的问题。
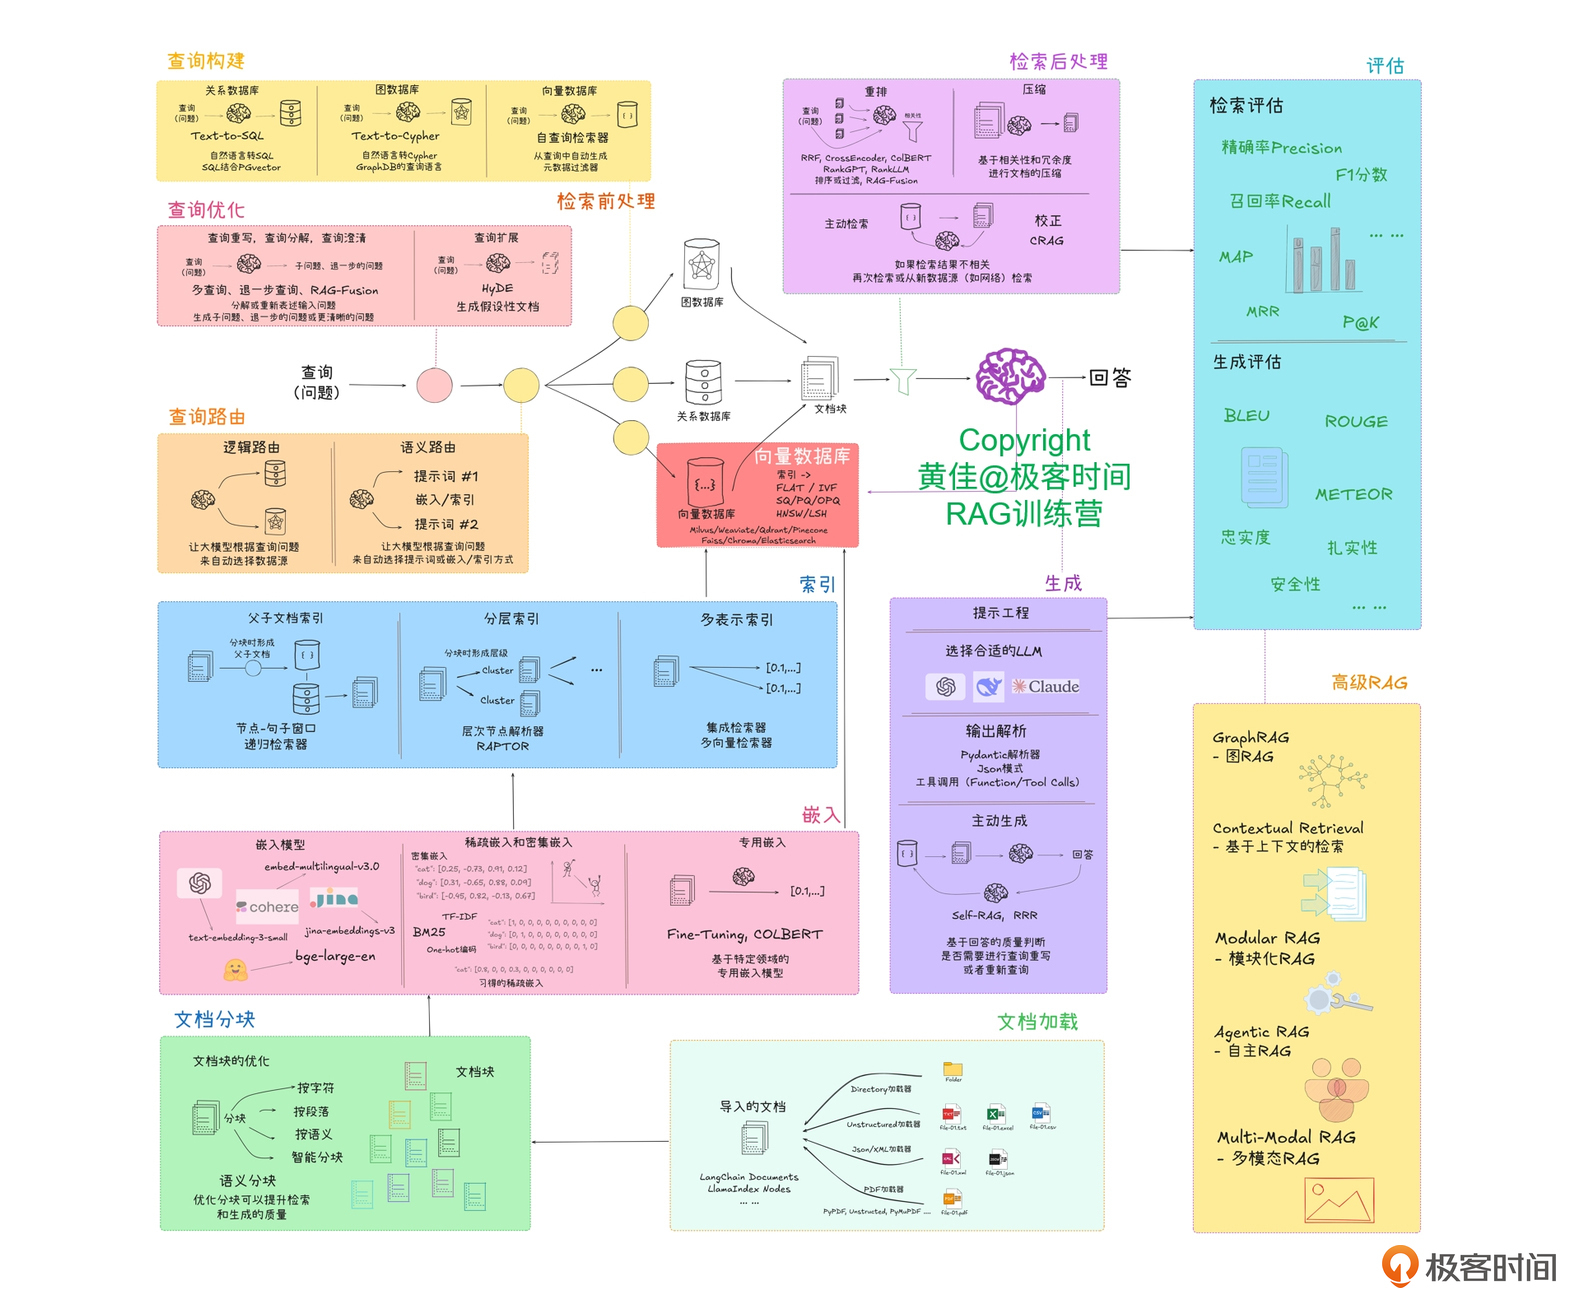
佳哥制作的 RAG 架构图
RAG 在 2023 年大火,2024 年泛滥,2025 年开始被反思,2026 年则正在被重新定位。Embedding、向量库、top-K、reranker 这些基础概念,我这一讲不重复(大家也可以去我的代码仓库里面去了解 RAG 相关知识点)。
我们聚焦一个更贴近记忆模块的问题:在 Agent 时代,RAG 怎样从“相似文本召回”,升级成“可用、可信、可追溯的证据取回”?
RAG 为什么算记忆,不算感知
我也曾思考过,RAG 最后不也是把几段材料塞进 context,让模型这一轮“看见”吗?为什么不把它归在感知模式?
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《Agent 设计模式之美》,新⼈⾸单¥68
《Agent 设计模式之美》,新⼈⾸单¥68
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论