

09|渐进发现:信息的觅食循环
黄佳
你好,我是黄佳。
前两讲我们讲了上下文分诊和语义压缩。上下文分诊管哪些信息能进 context,语义压缩管已经进来的信息怎么压。但它们有一个共同前提:你已经知道相关信息在哪。
不过如果 Agent 面对的是一个陌生代码库、一份没看过的合同、一段很长的事故日志,不知道相关信息在哪,只能自己探索出来。由此我们引入渐进发现(Progressive Discovery)模式,感知模块的第三个模式。
如何快速而准确地分析遗留代码库,是一个高频问题,在技术群组讨论中经常遇到。
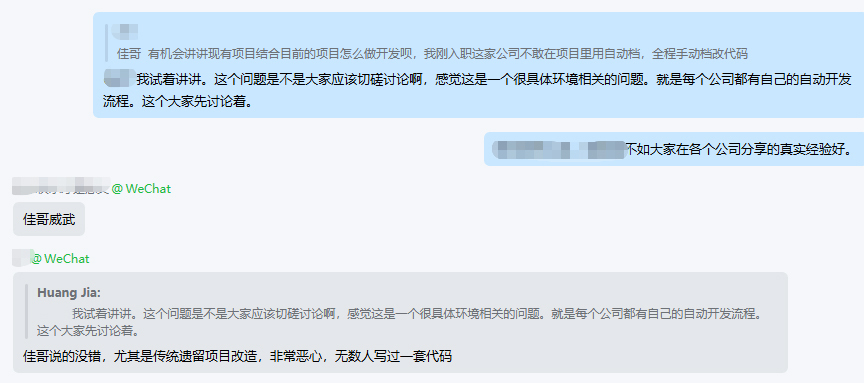
对大型遗留代码库进行准确的信息定位是个大问题
想解决图中的问题需要一套整体打法。比如做好知识工程、构建 AST 树、使用 RAG 等等。但在进入这些技术方案之前,我们先通过一个案例看看:遗留代码库到底难在哪里,渐进发现和这个问题有什么关系,以及为什么它能帮助 Agent 更好地理解老代码库。
比如说在一个电商系统中出现了 bug:订单确认邮件偶尔会混入其他客户的订单条目。开发团队接手时,面对的是一个 15000 文件的遗留代码库。文档稀疏,原作者走了,没人知道订单邮件 pipeline 具体走了哪些文件。
他们试了三种思路。
第一种,把整个代码库喂给 Agent 让它读。15000 个文件折下来大约 800K token,远超任何 LLM 窗口。切成 100 段并行喂的话,每段 Agent 都说“这一段没看到 bug”,因为它看不到全局。
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《Agent 设计模式之美》,新⼈⾸单¥68
《Agent 设计模式之美》,新⼈⾸单¥68
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论