

07|上下文分诊:如何科学分流处置不同信息
黄佳
你好,我是黄佳。今天我们正式进入第一个设计模式。
对于大模型的认知工程,有两个我们都知道的基本原则。
第一,大模型是没有记忆的。每次会话都是它第一次认识这个世界。
第二,大模型的认知窗口的大小是有限制的。我们永远无法把所有相关的内容都丢给它。
第一个设计模式由此展开。一旦 Agent 面对信息总量超出上下文窗口预算的场景,谁先进、谁等门外、谁压根不预加载,这就需要上下文分诊模式。这种情况是生产级 Agent 的常态,不是偶然现象,这件事本身没有任何难理解的地方,这一讲只是讲实现它的思路和具体方法。
如何理解上下文分诊模式
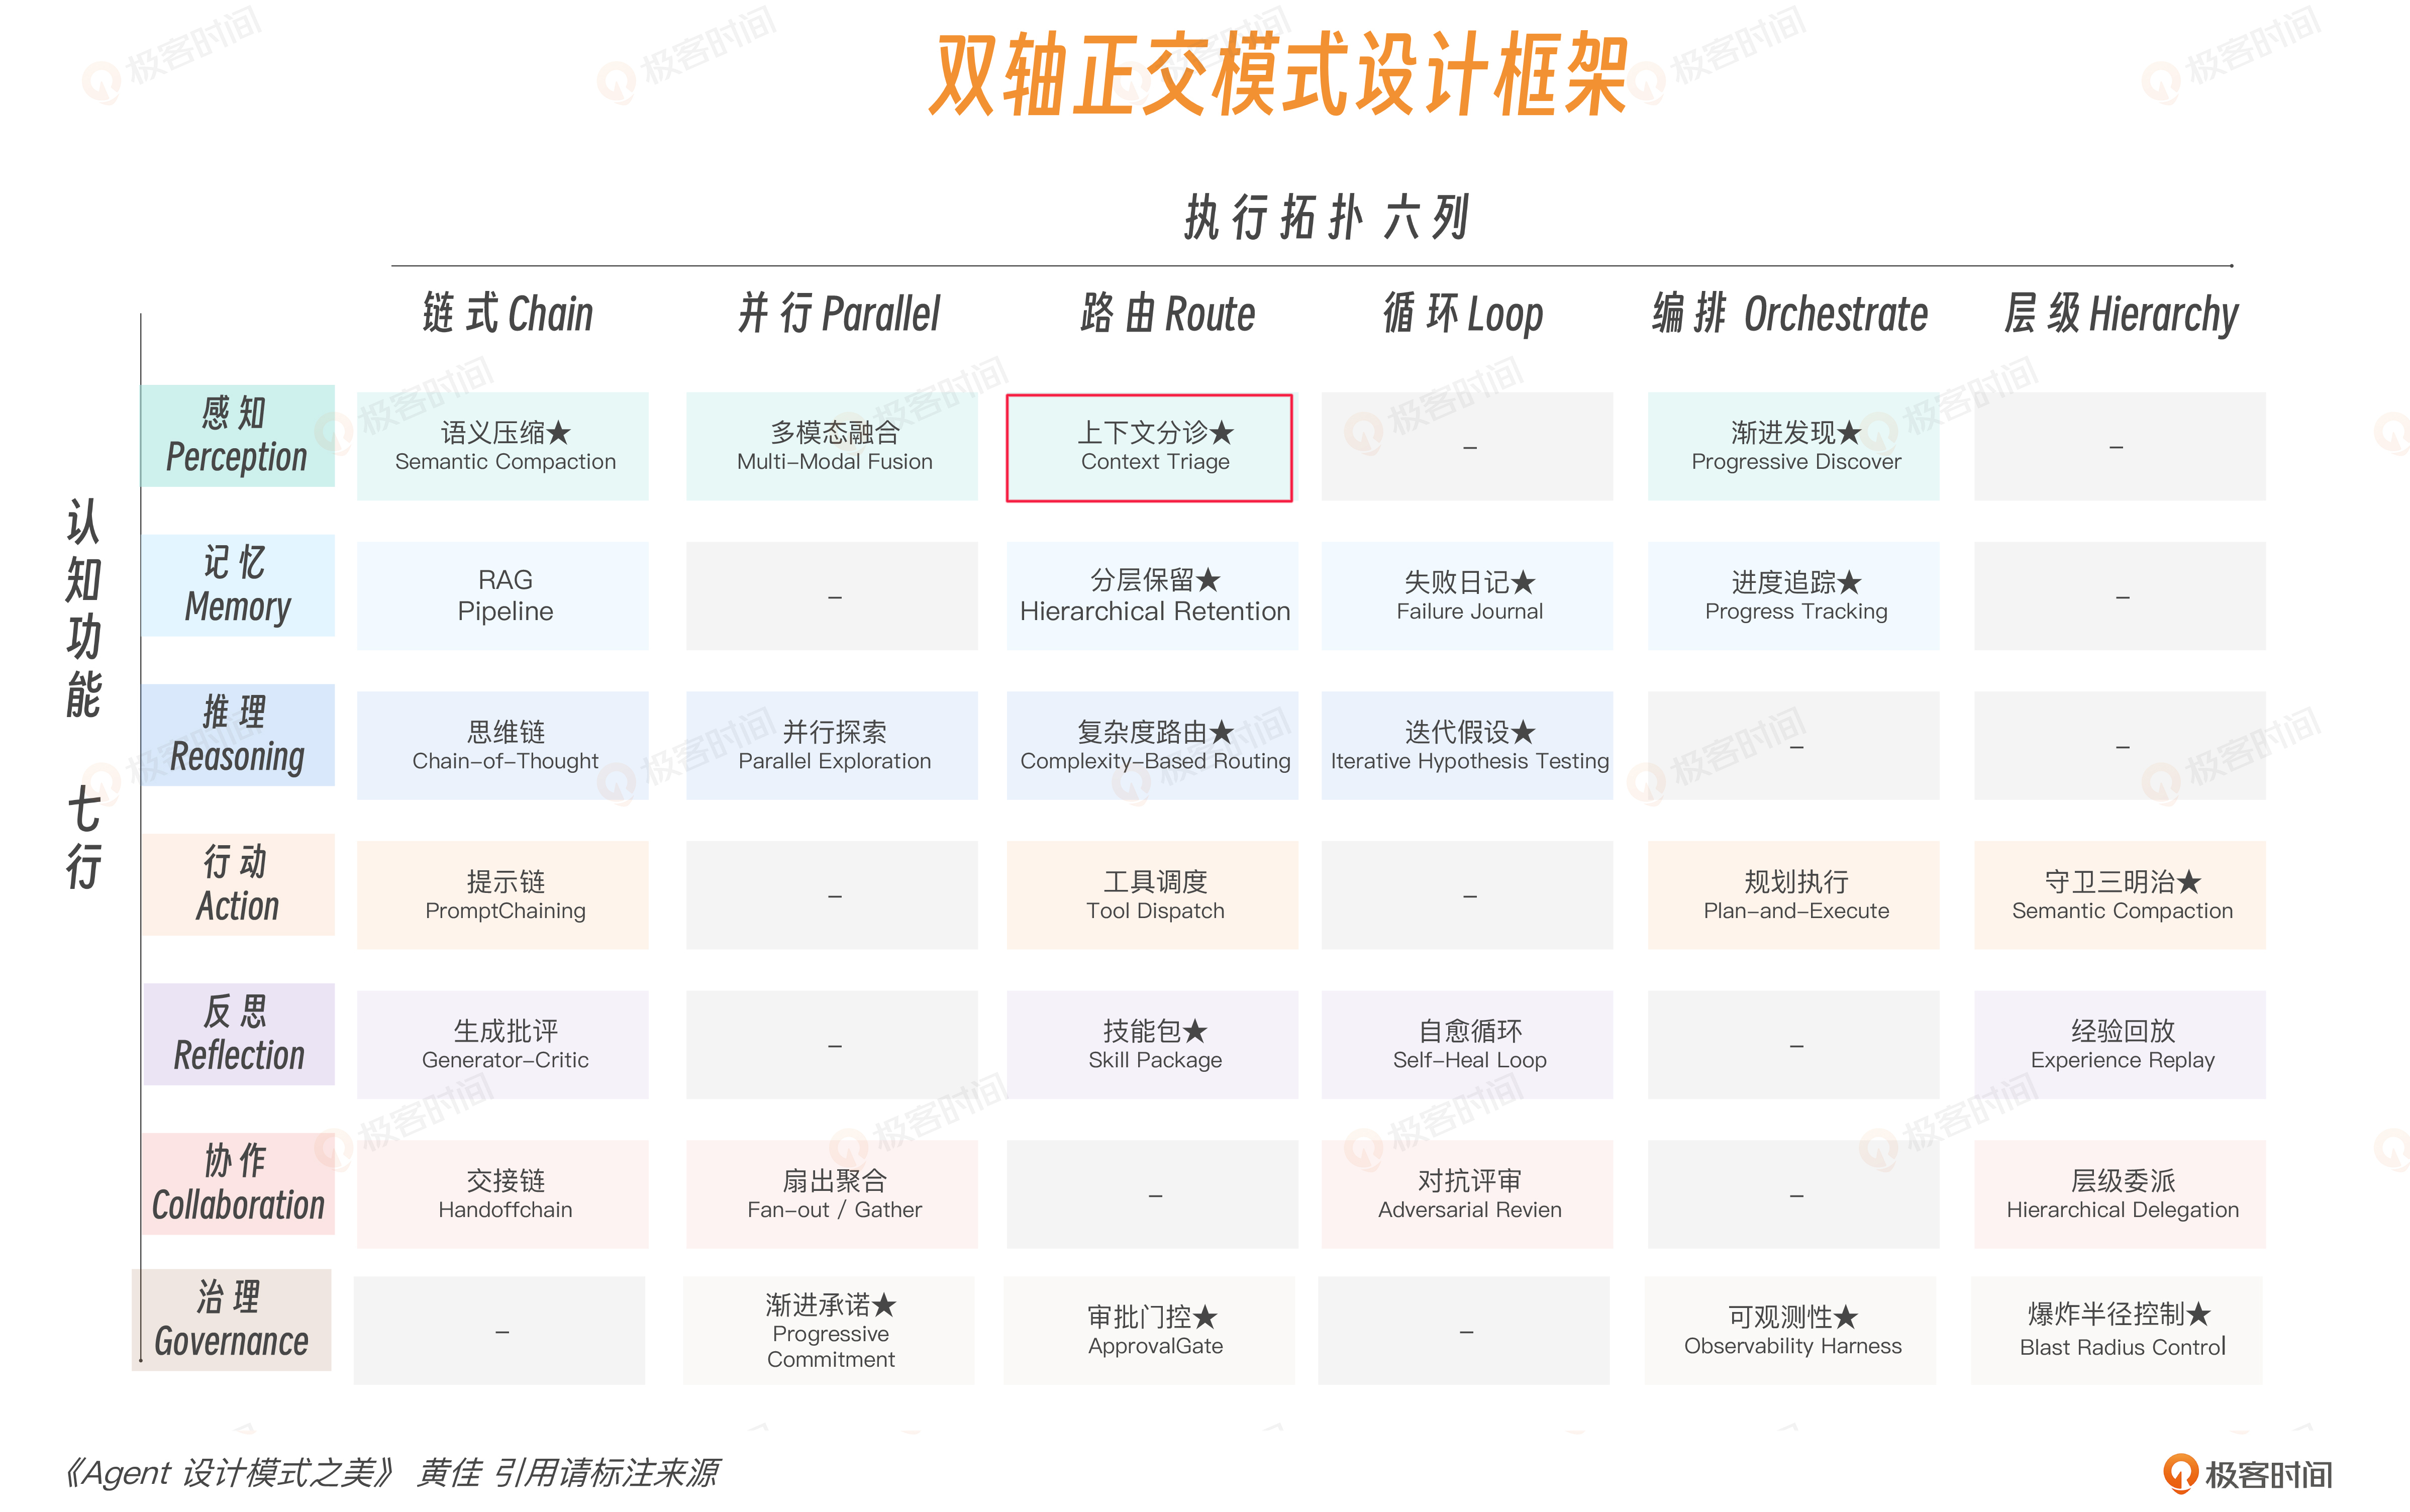
上下文分诊模式在双轴图谱里落在“感知 × 路由”的交点。
认知功能上它是感知,决定 Agent 看到什么;
执行拓扑上它是路由,按优先级把不同信息分发到不同处理路径。
上下文分诊模式(Context Triage)把所有候选 context 信息分成 P0/P1/P2/P3 四级,从高到低塞,塞到 token 预算耗尽。这就好比到了急诊室,每一个病人都希望早点见到医生,于是护士在急诊室会对病人做分诊。胸痛先看、脚踝骨折等等、头疼最后。她是在严重资源约束下做最廉价的优先级判断。
护士不是医生(她不需要是最聪明的模型,甚至可能不用模型😂),她不需要诊断完每个病人才能分诊,分诊本身就是那个快速判断。
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《Agent 设计模式之美》,新⼈⾸单¥68
《Agent 设计模式之美》,新⼈⾸单¥68
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论