

37 | 什么时候会使用内部临时表?
该思维导图由 AI 生成,仅供参考
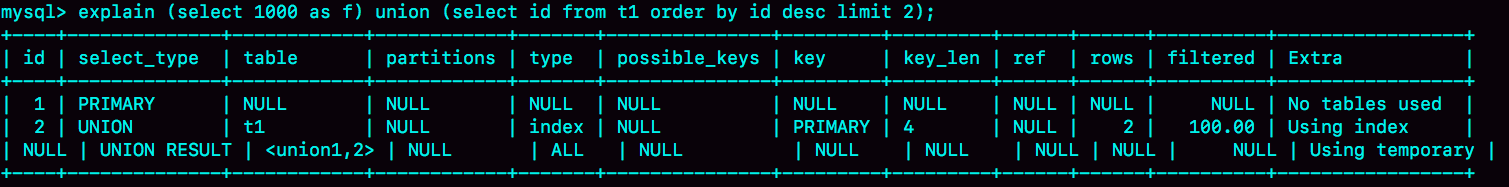
union 执行流程
 荧光笔
 直线
 曲线
- 深入了解
- 翻译
- 解释
- 总结
本文深入介绍了MySQL内部临时表的使用情况,重点讨论了在union和group by语句中的应用。在union语句中,内部临时表用于暂存数据并执行两个子查询的并集。通过示例展示了内部临时表的执行流程。对于group by语句,文章详细解释了其执行流程和优化方法,特别强调了通过索引优化group by语句的执行效率。通过这些例子,读者可以深入了解MySQL内部临时表的使用场景和优化方法,为他们在实际应用中提供了有益的参考。 文章还提到了group by的几种实现算法,并总结了一些使用的指导原则。例如,建议在group by语句后面加上order by null,尽量让group by过程用上表的索引,并根据数据量大小选择内存临时表或磁盘临时表。此外,通过使用SQL_BIG_RESULT提示,可以直接使用排序算法得到group by的结果。 总的来说,本文通过深入的技术分析和实例说明,帮助读者了解了MySQL内部临时表的使用方法和优化技巧,为他们在实际应用中提供了有益的指导。
《MySQL 实战 45 讲》,新⼈⾸单¥68

全部留言(65)
- 最新
- 精选
 老杨同志请教一个问题:如果只需要去重,不需要执行聚合函数,distinct 和group by那种效率高一些呢? 课后习题: 图8,把统计结果存内存临时表,不排序。id是从1到1000,模10的结果顺序就是1、2、3、4、5。。。 图9,老师把tmp_table_size改小了,内存临时表装不下,改用磁盘临时表。根据老师讲的流程,id取模的结果,排序后存入临时表,临时的数据应该是0,0,0,0,0,0,0,0,0,0,1,1,1,1,1,1,1,1,1,1,2,...... 从这个磁盘临时表读取数据汇总的结果的顺序就是0,1,2,3,4,5。。。
作者回复: 新年好 好问题,我加到后面文章中。 简单说下结论,只需要去重的话,如果没有limit,是一样的; 有limit的话,distinct 快些。 漂亮的回答👍
2019-02-065123 长杰图九使用的是磁盘临时表,磁盘临时表使用的引擎是innodb,innodb是索引组织表,按主键顺序存储数据,所以是按照m字段有序的。
作者回复: 👍🏿 春节快乐
2019-02-06477 天王内部临时表,和sort buffer,join buffer一样,都用来存放语句执行过程中的中间数据,辅助语句的执行。 使用用法 using temporary。 使用场景:1 数据一边查询,一边直接得到结果,不需要额外内存。比如:group by 需要计算。 2 join_buffer 是无序数组(单字段,可以重复),sort_buffer 有序数组,内部临时表是二维结构 3 用到二维表的特性需要用到内部临时表,比如 distinct ,group by 优化:1 group by 字段加索引 2 扩大临时表内存大小 3 如果数据量比较大,直接使用磁盘临时表 4 如果分组之后,不需要排序,手工 order by null group by 的顺序 1 创建一个内部临时表,初始化字段 a(分组字段) b(数量) 2 扫描表,一个个的判断,a字段值在临时表不存在,则插入(2,1),如果存在,比如(2,1),则加1,成为(2,2) 3 分组之后,默认会进行排序,如果不需要顺序,用 order by null。
作者回复: 👍很好的总结
2019-02-28251- Sinyo老师好, 我用infobright列式存储引擎explain出来一个group by语句, 发现也会用到内存临时表和文件排序、然后使用SQL_BIG_RESULT也有同样优化效果; 这是不是说明sort_buffer、join_buffer、内存临时表和磁盘临时表与数据库引擎类型其实是独立开的呢?
作者回复: 是的,非常好的验证和思考👍 sort_buffer、join_buffer、内存临时表和磁盘临时表 都是server层的,引擎间共用
2019-02-28342  IceGeek17文中说,SQL_BIG_RESULT这个hint,用来告诉优化器直接用磁盘临时表, 对于文中的例子 select SQL_BIG_RESULT id%100 as m, count(*) as c from t1 group by m; 则没有使用临时表,直接用了排序算法,这里有点不太明白,SQL_BIG_RESULT这个hint到底用来提示的是什么(是用磁盘临时表,还是就是直接使用排序,不用临时表)? 文中 “MySQL优化器一看,磁盘临时表B+数存储,存储效率不如数据来的高。那从磁盘空间考虑,还是直接用数组来存”,这段怎么理解? 是指MySQL优化器,直接忽略B+数的磁盘临时表(这里忽略的依据是什么?),并且从文中后续的分析来看,也没有用内存临时表,而是直接sort buffer排序,老师再详细解释下? 对于InnoDB的磁盘临时表,索引结构是B+数;那对于内存临时表,是不是就是数组结构?数组临时表的主键就是每个数组元素?
作者回复: 1. 最后的结果是“直接使用排序” 2. 就是认为用sort_buffer直接排序性能更好,所以就没有使用内存临时表或磁盘临时表 3. 没有索引的内存表可以认为就是数组; 主键不是,内存表的表结构,可以看一下38篇
2019-02-21529 Geek_41d472老师您好,课课后小结 2.尽量让 group by 过程用上表的索引,确认方法是 explain 结果里没有 Using temporary 和 Using filesort; 这里我有个疑问,文章的例子中explain 结果里,既出现了using index ,又出现了Using temporary 和 Using filesort,好像也是使用了所以啊,如果用你这个方法判断,那到底有没有使用索引呢?
作者回复: 只要是有Using filesort就表示有排序; Using index是表示使用了覆盖索引; 三个都出现就是使用了覆盖索引,但是覆盖索引的顺序扫描不能满足需求,只能排序,而排序过程用到了临时表
2019-04-2118 Li Shunduo请问Group By部分的第一个语句 explain select id%10 as m, count(*) as c from t1 group by m;为什么选择的是索引a,而不是primary key?如果字段a上有空值,使用索引a岂不是就不能取到所有的id值了?
作者回复: 因为索引c的信息也足够,而且比主键索引小,使用索引c更会好。 “如果字段a上有空值,使用索引a岂不是就不能取到所有的id值了?”,不会的
2019-02-07314 Long老师,新年好! :-) 有几个版本差异的问题: (1)图1中的执行计划应该是5.7版本以后的吧,貌似没找到说在哪个环境,我在5.6和5.7分别测试了,id = 2的那个rows,在5.6版本(5.6.26)是1000,在5.7版本是2行。应该是5.7做的优化吧? (2)图 9 group + order by null 的结果(此盘临时表),这里面mysql5.6里面执行的结果是(1,10),(2,10)...(10,10),执行计划都是只有一样,没找到差异。 跟踪下了下optimizer trace,发现问题应该是在临时表空间满的的时候,mysql5.7用的是:converting_tmp_table_to_ondisk "location": "disk (InnoDB)",,而mysql 5.6用的是converting_tmp_table_to_myisam "location": "disk (MyISAM)"的原因导致的。 查了下参数: default_tmp_storage_engine。(5.6,5.7当前值都是innodb) internal_tmp_disk_storage_engine(只有5.7有这个参数,当前值是innodb),5.6应该是默认磁盘临时表就是MyISAM引擎的了,由于本地测试环境那个临时表的目录下找不到临时文件,也没法继续分析了。。。 至于为什么MySQL 5.6中结果展示m字段不是0-9而是1-10,还得请老师帮忙解答下了。 还有几个小问题,为了方便解答,序号统一了: (3)在阅读mysql执行计划的时候,看了网上有很多说法,也参考了mysql官网对id(select_id)的解释: id (JSON name: select_id) The SELECT identifier. This is the sequential number of the SELECT within the query.(感觉这个读起来也有点歧义,这个sequential字面解释感觉只有顺序的号码,并咩有说执行顺序) 比如图1,文中解释就是从ID小的往大的执行的,网上有很多其他说法,有的是说ID从大到小执行,遇到ID一样的,就从上往下执行。有的说是从小往大顺序执行。不知道老师是否可以官方讲解下。 (4)我发现想搞懂一个原理,并且讲清楚让别人明白,真的是很有难度,非常感谢老师的分享。这次专栏结束,还会推出的新的专栏吗? 非常期待。
作者回复: 1. 是的,我默认是用5.7做的验证,这里5.7做了优化。 2. 其实你已经找到原因了,就是因为5.6的默认临时表是myisam表,而myisam表是堆表,这里的堆表,跟38篇介绍的memory引擎是类似的,你看了那篇应该就能知道为什么堆表是最后显示0那行了 3. 好问题,不同id从大到小,相同id从上到下 4. 多谢你的鼓励,还没定,先休息下^_^ 不好意思,你发的第一天就看到了,回复晚了😆
2019-02-1010 兔斯基老师,关于排序有几个问题。 order by id,主键 order by null, 不加order by 这三种写法哪种执行效率更高一些?后面两者是不是等价的?
作者回复: 这三种写法语义上不一样。。 如果对返回结果没有顺序要求,那写上order by null肯定是好的。 “order by null”和“不加order by”不等价,咱们文中有说哈
2019-02-119 梦康实践发现文中描述的 group by 执行过程中解释不通。案例如下 select `aid`,sum(`pv`) as num from article_rank force index(idx_day_aid_pv) where `day`>20190115 group by aid order by num desc LIMIT 10; 内存临时表不够,需要写入磁盘 select `aid`,sum(`pv`) as num from article_rank force index(idx_aid_day_pv) where `day`>20190115 group by aid order by num desc LIMIT 10; 内存临时表足够。 选的索引不一样,但是最后筛选出来的总行应该是一样的呀,所以现在更加困惑了。
作者回复: 看索引的名字猜测, idx_aid_day_pv 就是(adid, day,pv)这三个字段的联合索引? 这样的话,第二个语句就会顺序遍历索引,只要找到10个不同的aid就可以了,这个索引不用全部遍历;这样可以减少很多写入临时表的数据; 但是第一个语句是day开头的, 这样就必须将所有`day`>20190115的记录都存到临时表中,这个要写入内存表的数据行数肯定比第二个语句多的 所以核心就是这两个语句需要放入临时表的行数不同。
2019-02-1177

