大语言模型推理的开放训练方案【双语】

开放训练方案下的语言模型推理能力提升
Berkeley
Berkeley RDI Center on Decentralization & AI
90 人已学习 · 已完结
收藏

下载 App 随时随地学习

App Store 下载

Android 下载

扫描二维码下载客户端

你将获得

  • 如何通过角色设定与多样化数据生成提升模型在数学、推理、编程等领域的能力
  • 从指令微调(SFT)、人类反馈强化学习(RLHF)、直接偏好优化(DPO)到带可验证奖励的强化学习(RLVR)等多种后训练技术
  • 基于规则与自洽性检测的数据筛选方法,确保高质量、高多样性
  • 测试时推理扩展技术(如 S1 方法、自我引导增强生成 Self-REG),以及结合检索、批判与改进的闭环推理流程
  • 开放数据集、工具链与演示平台的使用,让研究者和开发者可以直接在开放环境中复现和拓展方法

课程介绍

本课程围绕“开放训练方案下的语言模型推理能力提升”展开,由华盛顿大学与 AI2 团队的 Hanna Hajishirzi 教授主讲,系统分享了从预训练、后训练到推理阶段(尤其是测试时推理扩展)的最新研究与实战方法。课程强调构建完全开放且可复现的语言模型生态,包括开放语言模型 OLMo 与开放后训练方法库 Tulu,覆盖数据采集、模型训练、能力评测到开放部署的全过程。
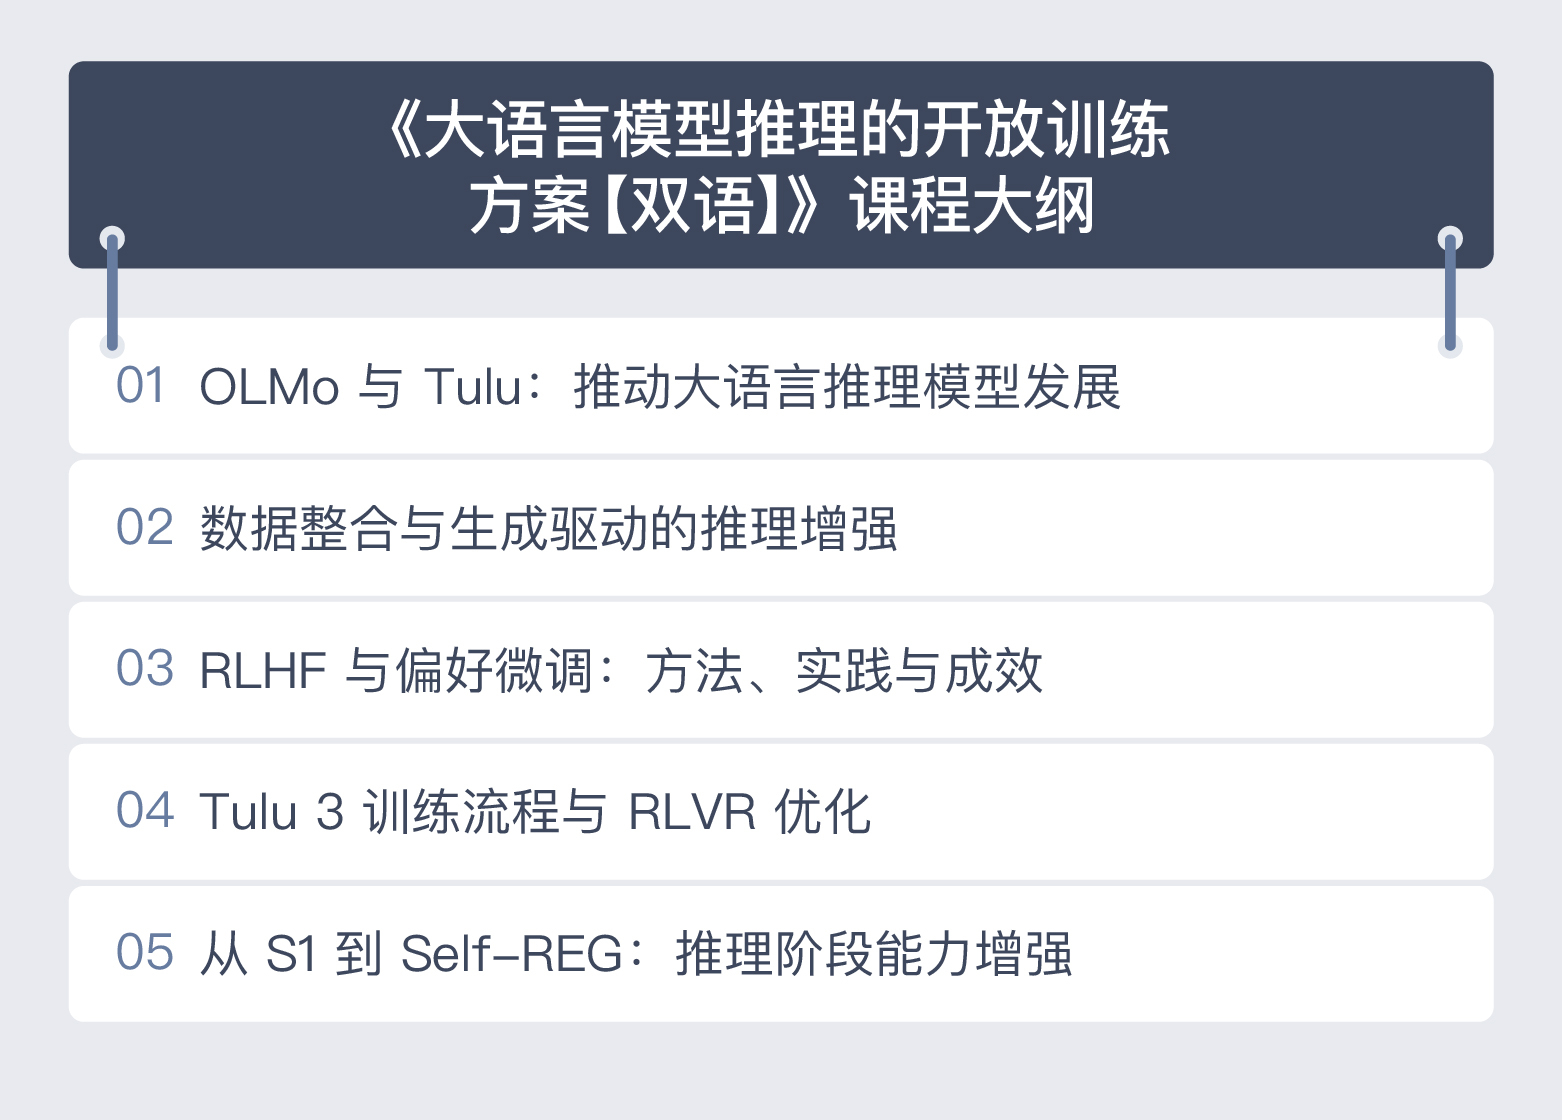
课程目录

订阅须知

本视频为公开课,订阅成功后,即可通过“极客时间”App 端、小程序端、Web 端永久阅读。

看过的人还看了

AI 应用实战课
黄佳
新加坡科研局资深研究员

25讲 | 4332 人已学习

¥59¥99
性能工程高手课
庄振运
Facebook 性能优化和容量管理高级专家

40讲 | 25598 人已学习

¥59¥129
快手 · 移动端音视频开发实战
展晓凯
快手回森技术负责人

25讲 | 13048 人已学习

¥59¥99
Web 协议详解与抓包实战
陶辉
智链达 CTO,前阿里云高级技术专家

121讲 | 43977 人已学习

¥68¥199