

👥 课程交流群
购课后,欢迎加入课程交流群,> 戳此加群 <
你将获得
- 深入解析 Codex / Hermes 的 Harness 机制
- 攻克长程 Agent 要解决的 20+ 个难点
- 实现一个自进化 On-call Agent(含配套代码)
- 建立可观测、可验证、可回滚的 Agent 进化闭环
- 提升 Agent 学习能力,构建受控 RSI
AI 导学
让 Agent 完成一次任务不难,难的是让它在长期值守中不偏离目标、不重复犯错,并把每次经验转化为可复用的能力。这门课围绕自进化 On-call Agent 的构建,聚焦两大核心:一是 Harness 机制如何承载任务目标、权限边界与运行状态,支撑 Agent 连续行动与长程工作;二是如何建立经验回流与验证闭环,通过记忆维护、Skill 演化和 A/B 测试,使改进可验证、可回滚、可共享。你将基于配套代码,逐步实现一个能巡检、调查、复盘并受控进化的智能体,理解从单次执行到持续学习的工程路径,掌握将人类工作方法转化为 Agent 可执行、可积累能力的关键实践。
课程介绍
为什么做这门课
让 Agent 写代码、跑测试,完成简单任务已经常态化。接下来,企业希望把更完整、复杂的工作交给它。因此,如何让 Agent 长期承担工作,并在使用中持续改进,成为 Agent 落地新挑战。
现实中,两个难点经常同时出现:人一离开,Agent 就可能忘记目标、丢失进度或越过权限边界;人纠正过的问题,换个会话,它又重新犯了一遍。每次都要守候和返工,Agent 的行动能力就很难真正转化为工作价值。
要跨过这道门槛,需要先让 Harness 接住目标、状态、权限和验收,再建立一条学习闭环:从工作中提炼经验,验证改进效果,让有效的方法进入后续任务。这正是《自进化 Agent 工程实战》要带你掌握的能力。
为此,我们邀请了国内头部大模型团队算法负责人 Tyler 老师,带你深入 Codex 与 Hermes 的 Harness 机制,逐步实现一个会积累经验、能够受控进化的智能体。
这门课教什么
课程以一名长期在线的 On-call(值班)Agent 为主线,提供配套代码。它平时巡检部署、配置和运行指标,收到告警后转入故障调查。遇到高风险操作,需要请求审批;得出调查结论,需要接受外部证据的检验。一班值守结束后,它还会复盘失败和人工纠正,为下一次工作提出改进。
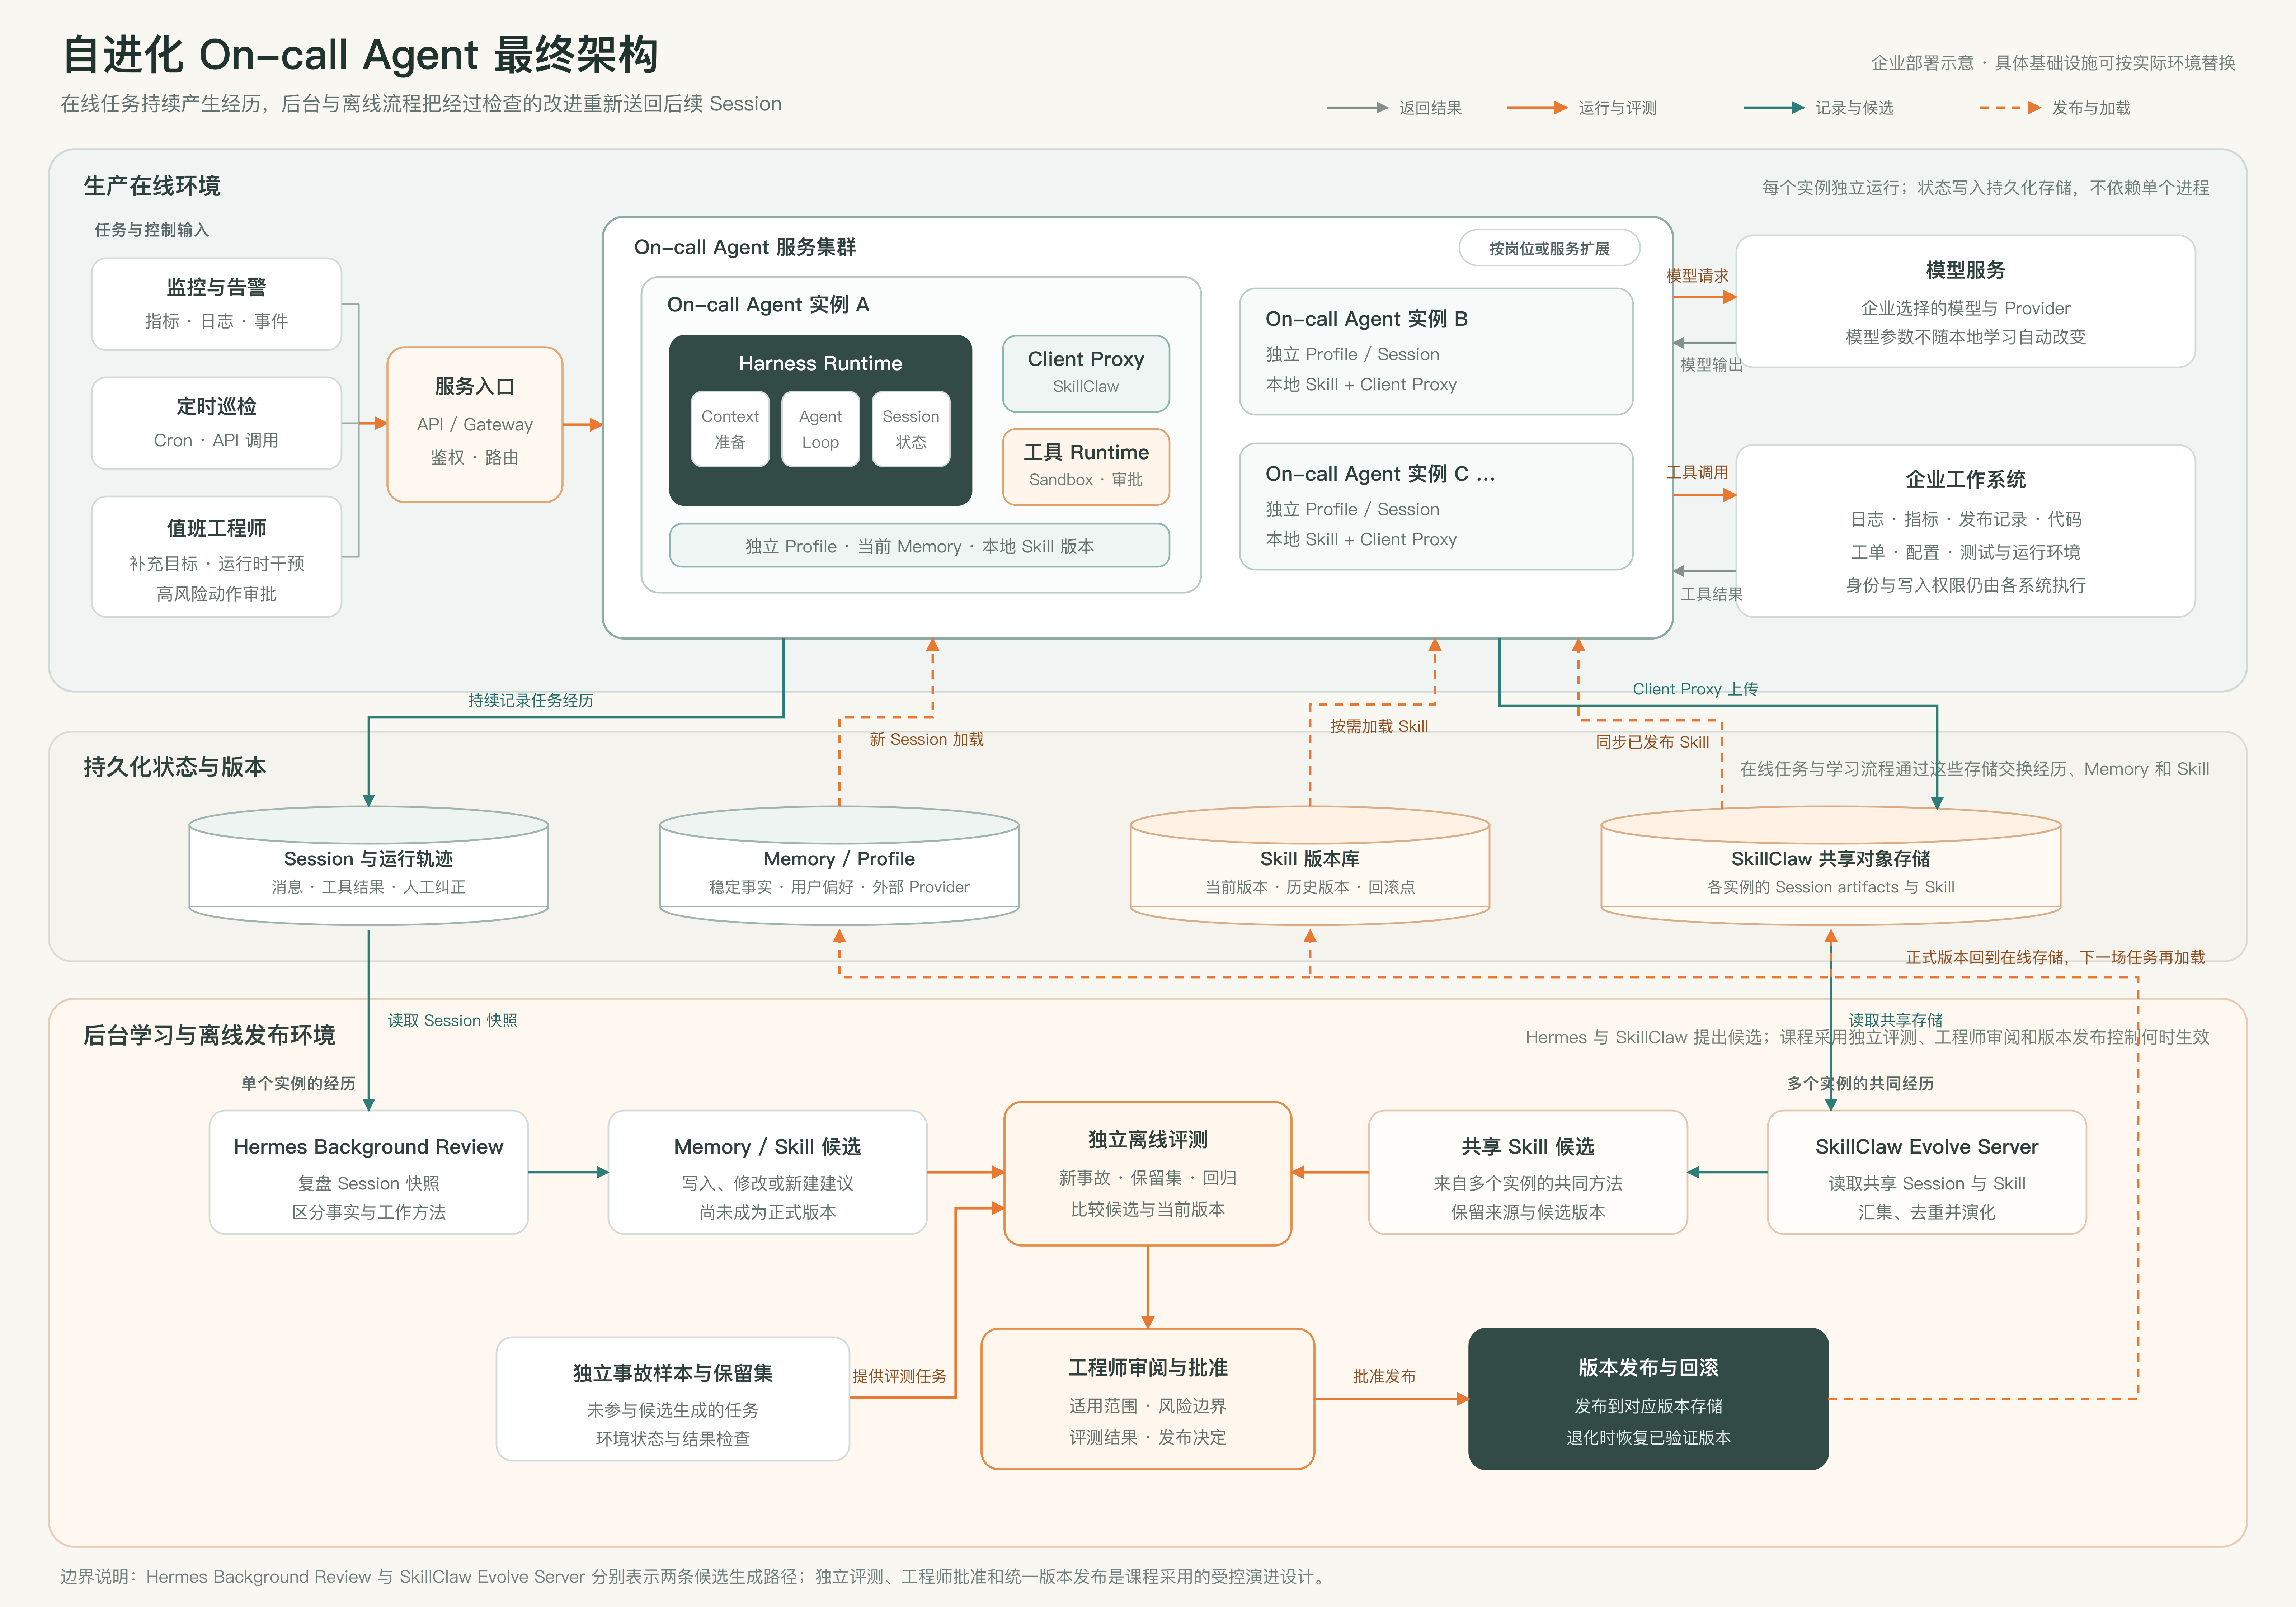
课程的五个篇章,就沿着这名 Agent 的能力成长逐步展开。
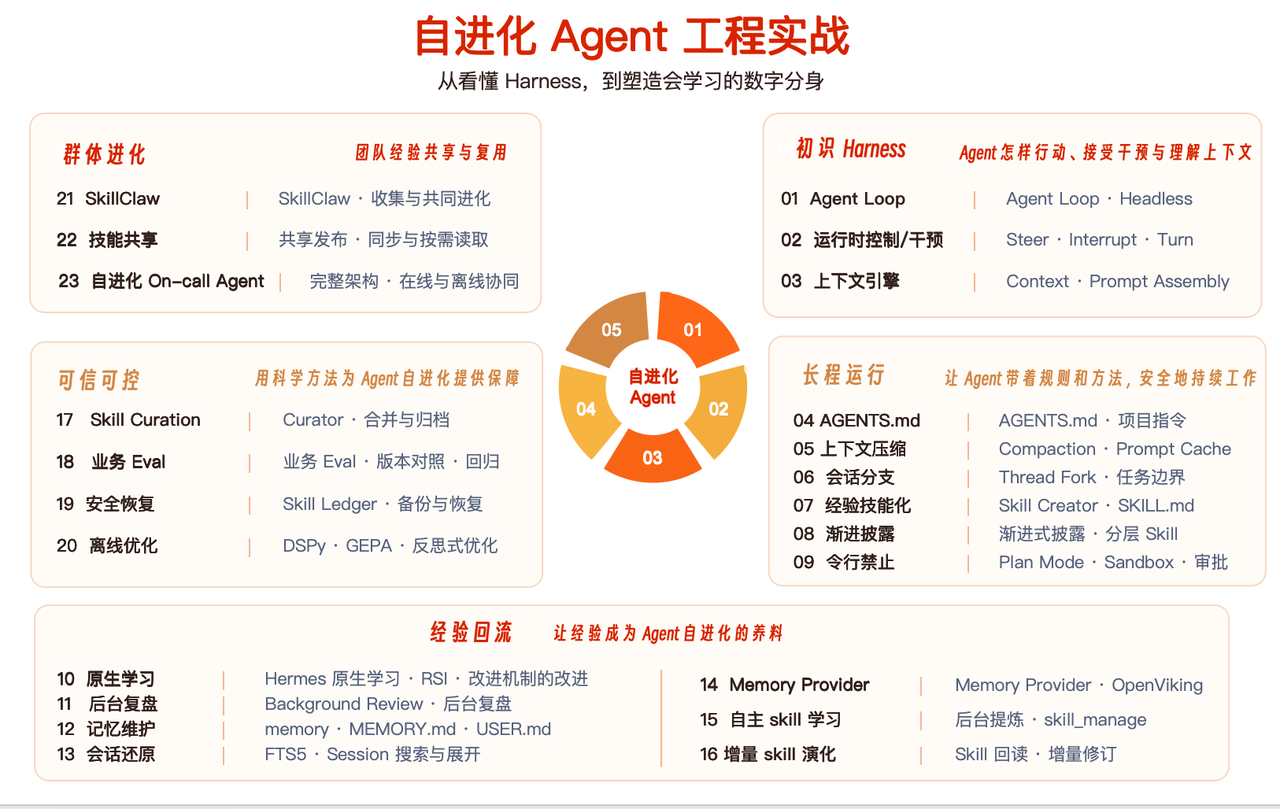
第一部分:初识 Harness,看懂一句要求怎样变成连续行动
从 Codex 入手,拆解 Agent Loop、运行时控制和上下文引擎。
你会看见 Agent 怎样决定下一步、调用工具并处理返回结果,也会理解工作中的新消息何时生效、模型每一轮究竟能看见什么。由此建立对 Harness 的整体认识,找到工程师能够干预任务的关键位置
第二部分:长程运行,让 Agent 带着目标、方法和边界持续工作
当任务持续几十轮、几百轮,怎样压缩历史而不丢失关键线索?怎样借助旧经历开启新的调查?怎样让规则持续生效,又避免把所有资料塞进上下文?这一部分将串起 AGENTS.md、上下文压缩、会话分支、Skill 和渐进披露,再通过隔离与审批限定行动范围。你将理解人类的提醒、守候和叫停,如何逐步由 Harness 系统机制承接。
第三部分:经验回流,让一次工作留下可复用的事实和方法
从这一部分开始,课程转向 Hermes,观察任务结束后的后台复盘与学习。
“日志已迁移到新入口”应该怎样写入 Memory?一次有效的故障排查,怎样提炼成 Skill?环境变化以后,旧记忆如何修正,老方法如何更新?
你将沿着后台复盘、记忆维护、历史会话检索、外部知识接入和 Skill 演化,理解 Agent 怎样从完成任务走向积累经验。
第四部分:可信可控,让新方法经得起验证,也退得回旧版本
经验越来越多,技能库怎样整理?新 Skill 在当前任务中有效,换个场景还能用吗?一次修改改善了部分结果,会不会损害原有能力?
课程将讲解 Skill Curation、业务 Eval、A/B 测试、安全恢复和离线优化。你会学习利用一批任务比较新旧方法,让改进经过评测、审批和版本管理,再进入后续运行。当运行持续产生经验,经过验证的经验又持续改善运行,就形成了课程所讨论的受控递归自我改进(RSI)闭环。
第五部分:群体进化,让一个 Agent 学到的方法成为团队能力
借助 SkillClaw,进一步观察不同 Agent 的经历怎样汇集、去重和验证,以及共享 Skill 怎样按岗位、项目和权限边界进入下一班值守。
最后,将这些机制组装成完整的自进化 On-call Agent:能够持续工作,提出经验更新,通过评测引入新能力,并在效果退化时回滚。
贯穿课程的能力进度是:连续行动 → 长程值守 → 积累经验 → 验证改进 → 共享能力。每一步都对应具体的工程问题,带你结合真实挑战,掌握自进化 Agent 设计方案。
学完你会获得什么
- Harness 机制理解。理解任务、上下文、状态和权限如何共同影响 Agent 行为。遇到执行偏离或效果波动时,知道从哪里检查、该调整哪一层机制。
- 一个亲手实现的自进化 On-call Agent。结合配套代码,串起持续运行、人工介入、结果验收和任务后复盘,为迁移到自己的业务场景建立实践基础。
- 一套把工作经验转化为 Agent 能力的方法。学会提炼和维护 Memory、设计和演化 Skill,让成功、失败与人工纠正成为后续任务可以利用的资产。
- 一条能够验证效果、管理版本和撤回错误的进化闭环。掌握新旧方法比较、离线优化和共享治理,既能推动 Agent 学习,也能判断它是否真的变好了。
当你下一次纠正 Agent 时,可以进一步让这次纠正成为经过验证的方法;当你把一项工作交给它时,也能把目标、边界和验收留在系统里。从看懂 Harness,到塑造会学习的数字分身,你将逐步把自己的工作方法转化为 Agent 能够执行、复用和持续改进的能力。
课程目录
适合人群
订阅须知

Tyler
国内头部大模型团队算法负责人