

08 | TAO & ReAct:走一步看一步,但是怎么走、怎么看?
邓明
你好,我是大明。
前面几讲我们一直在讨论 Plan 和 Replan。简单来说,Plan 解决的是整个任务应该怎么走,而 Replan 解决的是原来的路走不通了,接下来应该怎么改。
这节课我们就来讨论另外一个常见的范式:ReAct 或者 TAO。内容比较多,我会拆分成两讲,这一讲主要是讨论最基本的 ReAct 和 TAO 的实现要点,下一讲会重点讨论怎么提高 ReAct 的效果。
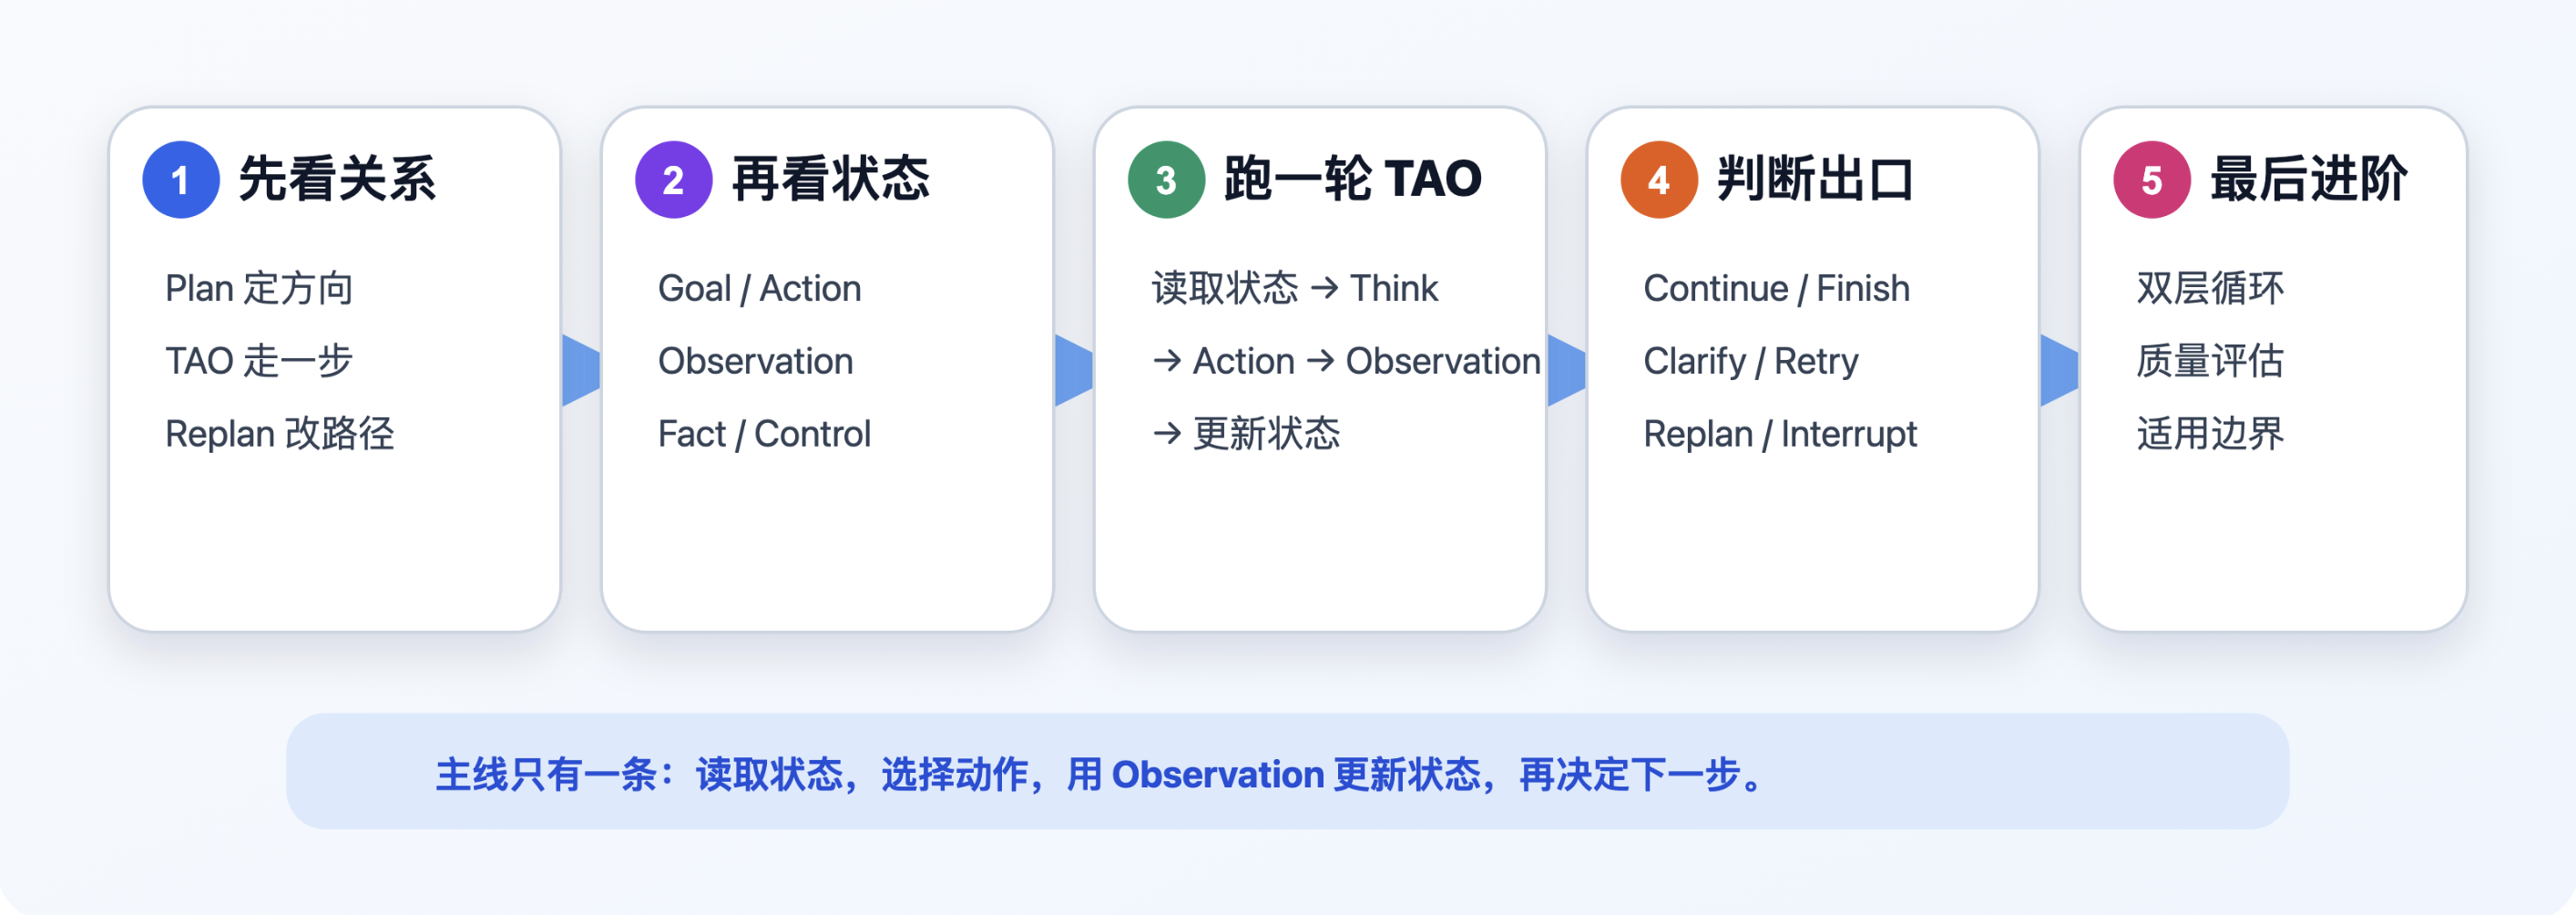
先来学习一点基础知识。
ReAct 和 TAO 是什么?
先简单介绍一下基本概念。ReAct 一般被解释为 Reasoning and Acting,也就是将推理和行动交替进行。
如果你是学生或者是这一年才开始接触 Agent 的,那么你碰到的各种 Agent 差不多都是 ReAct 这种形式。早期的 Agent 通常都是接收用户输入 - 调用大模型直接生成答案。而 ReAct 的运行过程更接近:输入 - 思考 - 执行动作 - 获取结果 - 再次思考 - 再次执行动作 -(多次循环)- 最终输出。
你可以通过这张图来看出两者之间的区别。
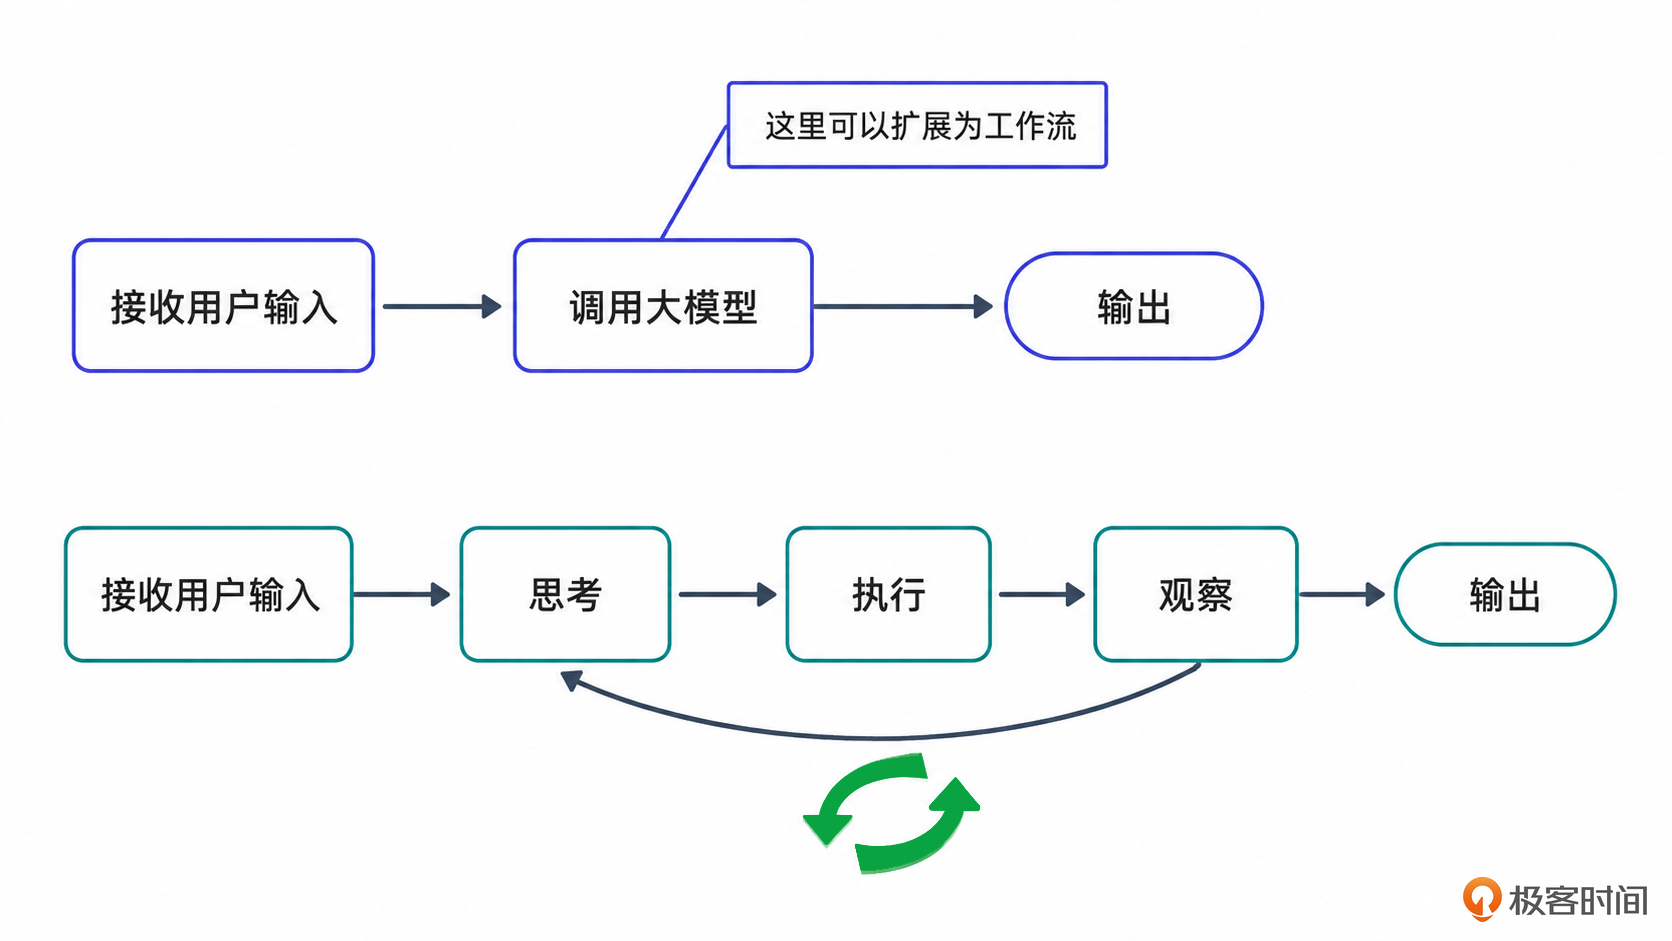
举例来说,用户输入:“现在广州天气怎么样?适不适合去爬山?”。此时大模型不能只凭自己的知识回答,因为天气是实时变化的。于是它可以先思考:“我需要先查询广州当前的天气。”,而后执行天气查询工具,拿到天气结果,再继续思考:“当前温度是 33℃,有雷阵雨,因此不适合长时间户外爬山。”
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《AI Agent 系统设计面试现场》,新⼈⾸单¥59
《AI Agent 系统设计面试现场》,新⼈⾸单¥59
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论