
开篇词|判断层为什么会成为 AI 应用的新基础设施?
Kevin
讲述:张浩AI版大小:12.58M时长:11:00
你好,我是陈康贤,笔名 Kevin。
2026 年 9 月 15 日,TypeSafe AI 发布了一个有点“怪”的模型,叫 Jev。它不会聊天,不会写代码,一个字也不生成。你给它一段材料和几个事先定义好的问题,它只告诉你每个答案的概率。
就是这样一个“不会说话”的模型,发布 5 天就从排队申请变成了全面开放;Vercel、Netlify、Cloudflare、OpenRouter 这些开发者平台相继接入;不到十天,社区里基于它的项目就超过了 190 个。不到一个月,亚马逊云科技(AWS)开源了自己的同类模型,OpenAI 也推出了同类接口。这类只做判断、返回概率的模型,开始有了一个统一的名字:决策模型(Decision Model)。
如果你也在做 AI 应用,看到这个消息,你是什么想法呢?
对我来说,我最想搞明白的是三个问题。第一,一个不会说话的模型,凭什么一下子就火了,还让大厂迅速跟进?第二,它背后的“判断层”到底是什么,会不会像当年的数据库一样,成为 AI 应用绕不开的基础设施?第三,如何快速学习这个模型,并为自己的工作所用?
相信读完这篇开篇词,这三个问题你就有了答案。
Jev 凭什么一下子火了?
先看看大家拿 Jev 做什么:工单分流、内容审核、反欺诈、模型路由,电商里的类目归属、属性抽取、假货识别,社区项目则集中在 Agent 安全护栏、邮件分拣和交易风控。这些事有一个共同点:过去几乎都是靠“让大模型输出 JSON”来做的。
所以 Jev 火的原因,用一句话总结就是:它治好了一个几乎每个 AI 应用都有的老毛病,用写作文的大模型去填选择题的答题卡。
那这个毛病出在哪儿呢?我们来看一段似曾相识的代码。它在判断一条评论是不是投诉:调用大模型,从返回的文本里抠出 JSON,解析失败就重试,重试用完就返回默认值。
这段代码写得并不差,但隐藏着三个毛病。就算我们要求 AI “写得更仔细”,问题还是无法根治。
第一是格式不可靠。大模型每一步都在整个词表里挑下一个字,“只输出 JSON”对它只是一条建议,它可能在前面加一句“好的,以下是结果”,也可能把字段名改成中文。结构化输出模式能保证 JSON 合法,却管不了取值对不对。TypeSafe 发布 Jev 时做过统计(见图 0-1):受测大模型的结构化输出错误率从 0.58% 到 45.5% 不等。
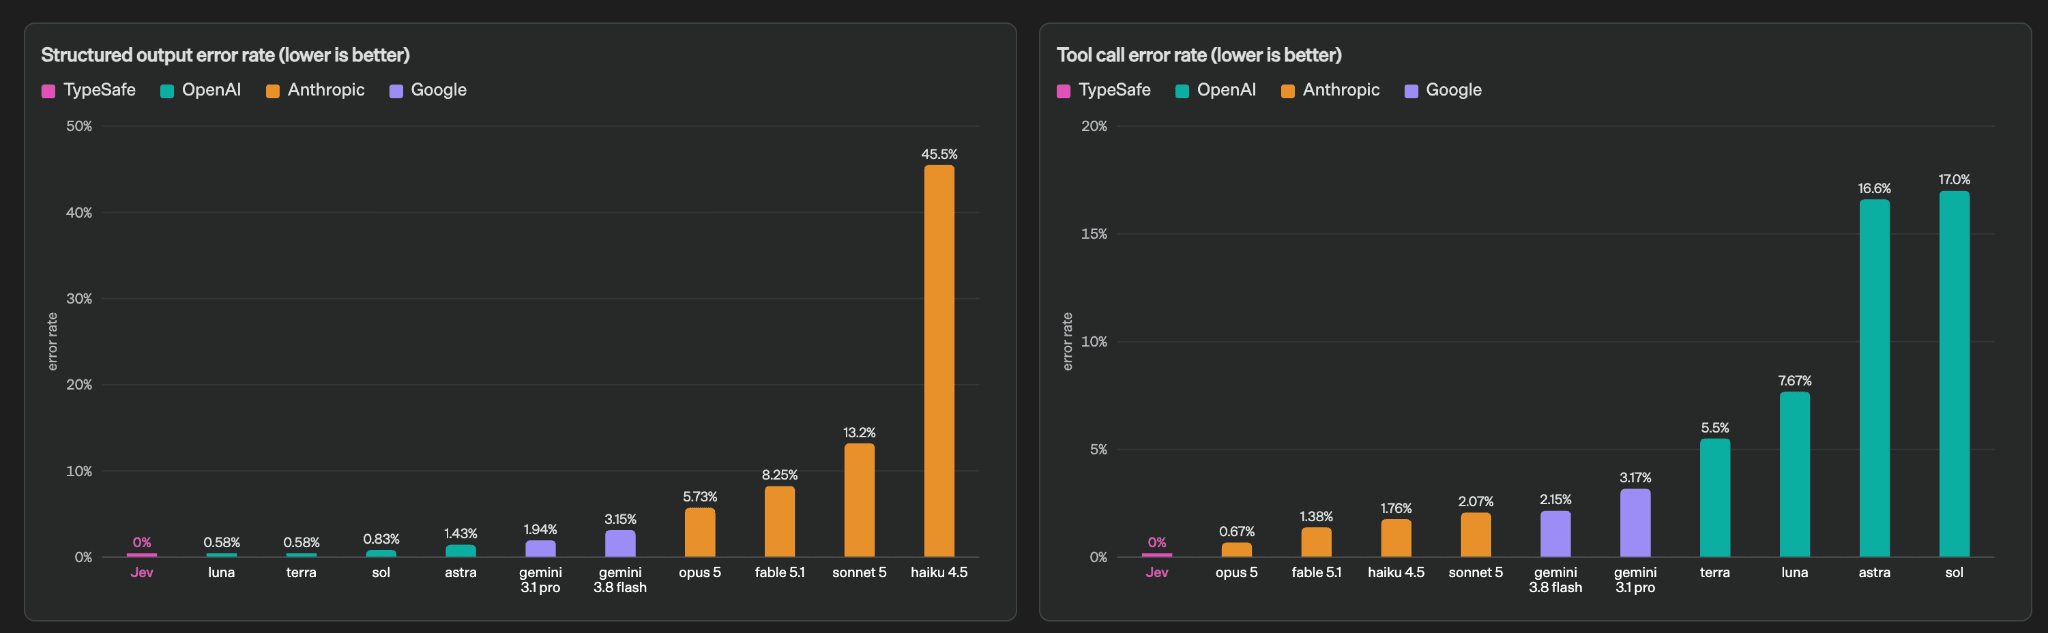
图 0-1 TypeSafe 发布时的统计:大模型的结构化输出错误率(左)与工具调用错误率(右)
参考原图来源:TypeSafe 发布博客《Introducing System One Models & Jev》。左图为结构化输出错误率,右图为工具调用错误率;luna、terra、sol、astra 为 OpenAI 的模型。
第二是又慢又贵。“是不是投诉”只有两种答案,大模型却得把整段 JSON 一个字一个字写出来,推理模型还要先写一大段看不见的思考过程,这些都按更贵的输出计费。
第三最容易被忽略:你不知道它有几成把握。函数只返回 True 或 False,模型是十拿九稳还是几乎在随机猜测?你看不出来。让它顺便报个置信度也没用,同一条评论问两次,可能一次 0.9、一次 0.7,因为那个数只是它写出来的又一段文字,没有经过校准。
三个毛病,根子是同一个:大模型的接口是“文字进、文字出”,而判断需要的是“材料进、带概率的答案出”。Jev 恰好把这件事做对了。
判断层到底是什么?
有了前面的铺垫,判断层就好理解了。用一句话总结就是:判断层是代码和大模型之间,专门负责“做选择题”的那一层。
大模型相当于是问答题,它的输出通常是一大段文本,可能需要你从中提炼答案;判断层则是一张答题卡:选项是你事先印好的,它只能在选项里涂,每个选项旁边还标着有几成把握。
所以,判断层的接口至少要做到三点:答案范围由你来定;返回代码能直接用的值;每个答案都带着概率,让代码决定哪些自动处理、哪些交给人。
Jev 就是按这三点设计的。你给它一份输入状态,也就是要判断的材料,再给它一组问题。问题分三类:多选一(Choice)、等级打分(Score)和是非判断(Noul)。放到电商里,“这个商品属于服饰、数码还是家居”是多选一,“这条描述夸大宣传的程度是轻微、明显还是严重”是等级打分,“这两个商品是不是同一款”是是非判断。它们都是懂行的运营扫一眼就能判断的事,只是量太大,人看不过来,规则又写不全。
判断层放在系统的哪里?
有了判断层,AI 应用就形成了三层分工,这也是贯穿整门课的一句话:代码负责计算,Jev 负责判断,大模型负责推理和创作。
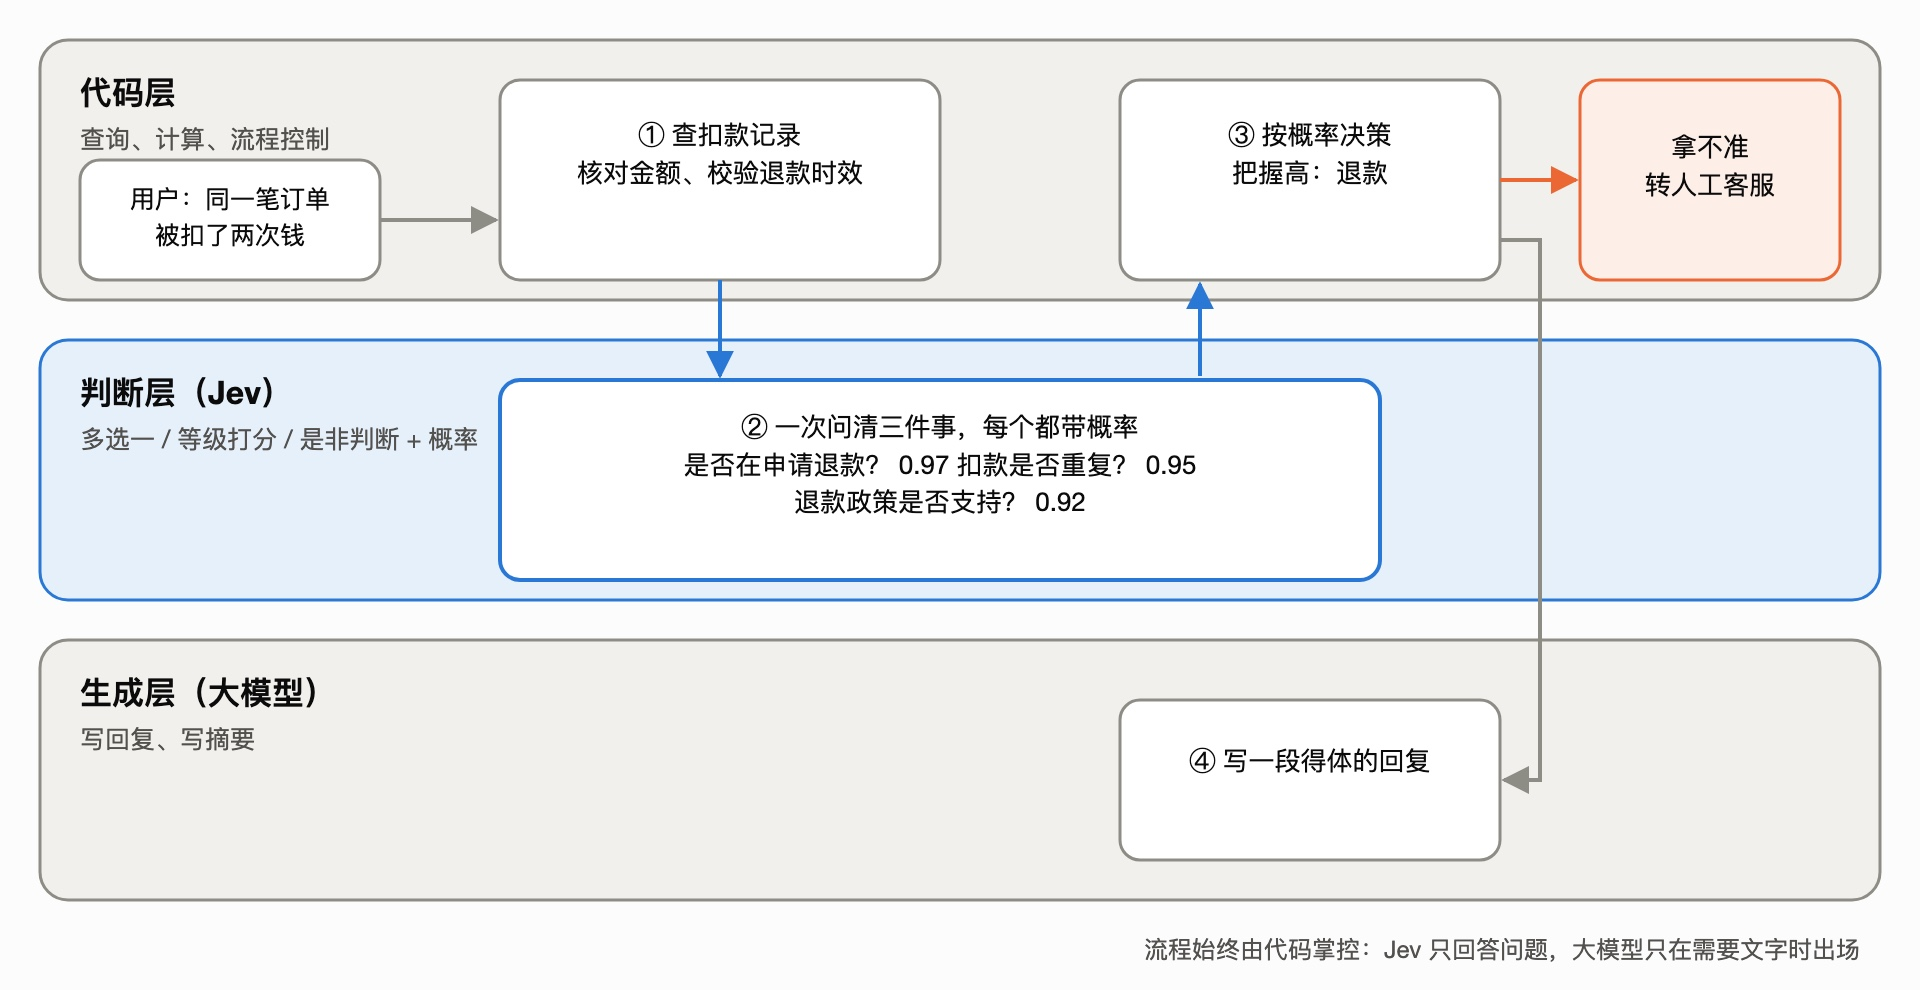
图 0-2 三层分工:以重复扣款退款为例。代码负责查询和决策,Jev 一次回答三个带概率的问题,大模型只负责写回复,拿不准的转人工
拿重复扣款来说。用户发来一句“同一笔订单被扣了两次钱,麻烦退一下”。代码先查扣款记录、核对金额和退款时效;再把用户消息、扣款记录和退款政策交给 Jev,一次问清:用户是不是在申请退款,扣款是不是真的重复,政策支不支持;代码根据答案决定退款,最后才让大模型写一段得体的回复。Jev 拿不准时,再转给人工客服(见图 0-2)。
你会发现,流程始终由代码掌控。Jev 只回答代码问它的问题,大模型只在需要文字时才需要调用。
判断层为什么会成为基础设施?
理解了判断层是什么,我们来回答开头的第二个问题。
不妨先回想一下数据库是怎么变成基础设施的:大家都通过 SQL 这个标准接口存取数据,底层换成哪家,应用基本不用改。一样东西能成为基础设施,通常有三个特征:接口标准,便宜到不假思索地调用,行为可以预期。这三个特征,判断层身上都已经冒头了。
先说接口。“输入状态加结构化问题”这种调用方式,已经不属于某一家公司了。OpenAI 的决策接口同样返回是非、多选一和打分三类带概率的答案;AWS 开源的决策模型也是在选项里作答、给出把握;开源社区还出现了和 Jev 请求格式一致的替代模型,改个服务地址就能切过去。
再说成本。Jev 只对输入计费,独立测试测出来它比前沿大模型便宜、快得多,具体倍数第 02 讲细说。成本低到一定程度,做法就会变:以前只在用户举报后才审核一条评论,现在可以每一条都审。
最后说可预期。Jev 的设计者说过一句话:如果一个模型 95% 的时候能做对,却说不出自己什么时候落在那 5% 里,它就没法把这件事自动化。每天审核 100 万个商品,95% 的准确率意味着约 5 万个错判,业务方只能全部复核;但如果模型能把 80 万个标成“很有把握”,而这部分确实很少出错,人工就只需要看剩下的 20 万个。这个前提叫作校准:模型报出的概率要和实际正确率对得上。
有一点要分清:会成为基础设施的是决策模型这一类东西,不一定是发布 Jev 的这家公司。我的看法是,Jev 的护城河并不高。它发布时就宣布了 4000 万美元融资,可调用方式一公开,大厂几周内就拿出了同类产品。它最后能不能在商业上成为新的一极,现在谁也说不准;但大厂跟进得这么快,恰恰说明决策模型正在成为新的范式。就像数据库,最后留下的厂商不止一家,而会用数据库成了每个工程师的基本功。
当然,这些多是厂商自己的说法。TypeSafe 的评测是拿 Jev 的答案去对两个顶级大模型的共同判断,而不是对人工标注的标准答案;它也承认 Jev 的中文效果不如英文。所以还差最后一步:它的效果必须能被你自己验证。
这门课能帮你做成什么?
最后来回答第三个问题。既然决策模型会成为 AI 应用的底座,学会用好它,比选中哪一家厂商重要得多。
所以这门课讲的是一类模型的应用,也就是决策模型在 AI 应用里怎么应用、怎么落地、怎么验证。之所以以 Jev 为例,是因为它最早发布、资料最全;出题、定阈值、搭评测、算成本这些方法,换到其他厂商的决策模型上同样适用。全课 22 讲分成六个模块,最后是一讲综合实战(见图 0-3):
认知篇(01–02 讲):Jev 和大模型的区别,以及选型地图;
上手篇(03–06 讲):接入、题型选择、问题设计和成本核算;
工程篇(07–09 讲):阈值怎么定、评测怎么搭、上线后怎么保障效果,这是方法论的核心;
电商篇(10–15 讲):类目预测、同款识别、属性抽取、审核、搜索相关性、客服售后,这是全课重点,也是我在商品系统里做了很多年的领域;
Agent 篇(16–18 讲):Agent 的每一步决策、模型路由和安全护栏;
场景拓展篇(19–21 讲):邮件分拣、知识库问答和交易风控;
综合实战(22 讲):搭一条商品审核流水线,也聊聊什么时候不该用 Jev。
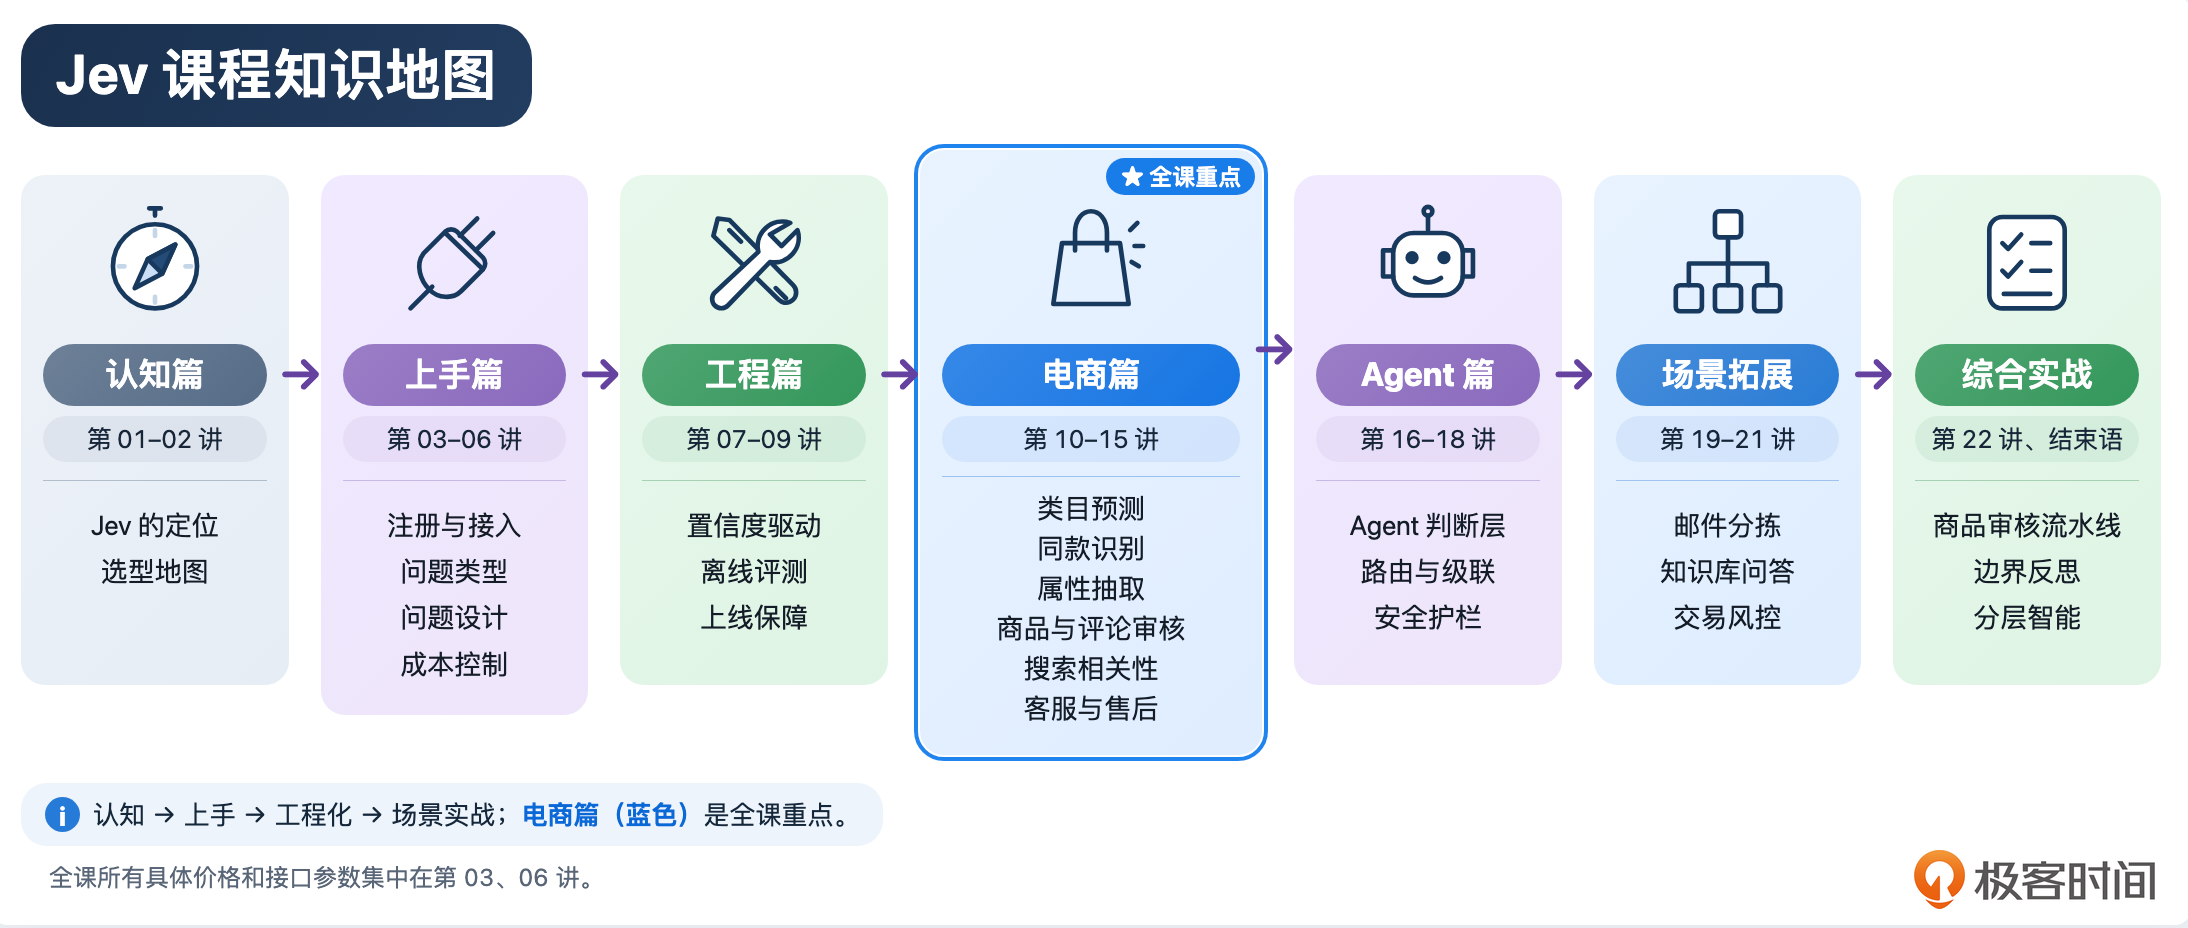
图 0-3 课程路线图:六个模块和综合实战从认知、上手、工程化一路走到场景落地,蓝色的电商篇是重点
案例讲会尽量用公开数据复现,给出准确率、成本和延迟的对比;所有数字要么是实际跑出来的,要么有公开出处。学的时候,我建议你边学边动手,准备一份自己的业务样本,哪怕只有几百条,也足以验证它在你的场景下准不准。
学完这门课,我希望你带走三种能力:分辨,知道一个问题该交给代码、决策模型还是大模型;落地,能把模糊的需求拆成清晰的问题,按判错的代价定好阈值;算账,能算清成本、延迟,以及多少能自动处理、多少要留给人。哪天你换成了另一家的决策模型,这三种能力依然有用。
那决策模型适合用在哪里?我的看法是,凡是答案能事先列出来、量大到人看不过来的判断,都可以交给它,比如电商类场景里面,类目归属、商品审核、工单分流和风险初筛,能用的场景非常多,这也是它很有可能成为 AI 应用基础设施的原因。落到自己的工作里,可以先挑一个高频的判断跑通。
这门课适合做 AI 应用的同学,包括但不限于 AI 工程架构设计、AI Agent 应用,以及 AI 在电商、客服领域的应用,会写 Python、调用过大模型 API 就够了。课程每讲正文会给出关键代码,文末参考资料既能用来核对数据,也可以让你自己复现结果。
我是 Kevin,在电商行业做了十几年技术,在互联网大厂做过商品、交易等电商核心链路,近年也做过一些 Agent 架构、RAG 和模型微调的落地。在电商系统里,正好有大量这样的判断题,适合用 Jev 来解决。
好,从下一讲开始,我们先从 Jev 这个名字说起,看看它和普通的大模型到底有什么不一样。
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
2026-11-03给文章提建议
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《Jev 决策模型工程实践》,新⼈⾸单¥59
《Jev 决策模型工程实践》,新⼈⾸单¥59
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论