

06|分路召回架构:如何避免安全红线被向量检索“漏掉”?
李号双
你好,我是李号双。
在这节课正式开始之前,你先来想象一个场景:周三下午,你正喝着咖啡审查代码。六周前,你在代码审查会上拍着桌子定下的铁律:“禁止使用 ORM,所有数据库操作必须用原生 SQL”。当时,你特意把这条规范整理成一条 Memory,描述得清清楚楚,存进了 Agent 的向量库。你以为这件事彻底解决了。今天,你让 Agent:“给报表模块写一个数据库访问层”。
它爽快地输出了代码。你扫了一眼,看到了 SQLAlchemy 的导入语句。手里的咖啡差点没端稳。
这不可能。你打开召回日志,看到了这样的逻辑:
你盯着那个 0.38 陷入了沉思。
在向量空间里,“禁止使用 ORM”和“写数据库代码”的相似度只有 0.38——达不到 0.45 的召回阈值。Agent 没有报错,没有犹豫,它只是按它看到的上下文在干活,它根本不知道有这条禁令存在。对它来说,用 SQLAlchemy 和用原生 SQL 没有区别,都是“写数据库代码”。
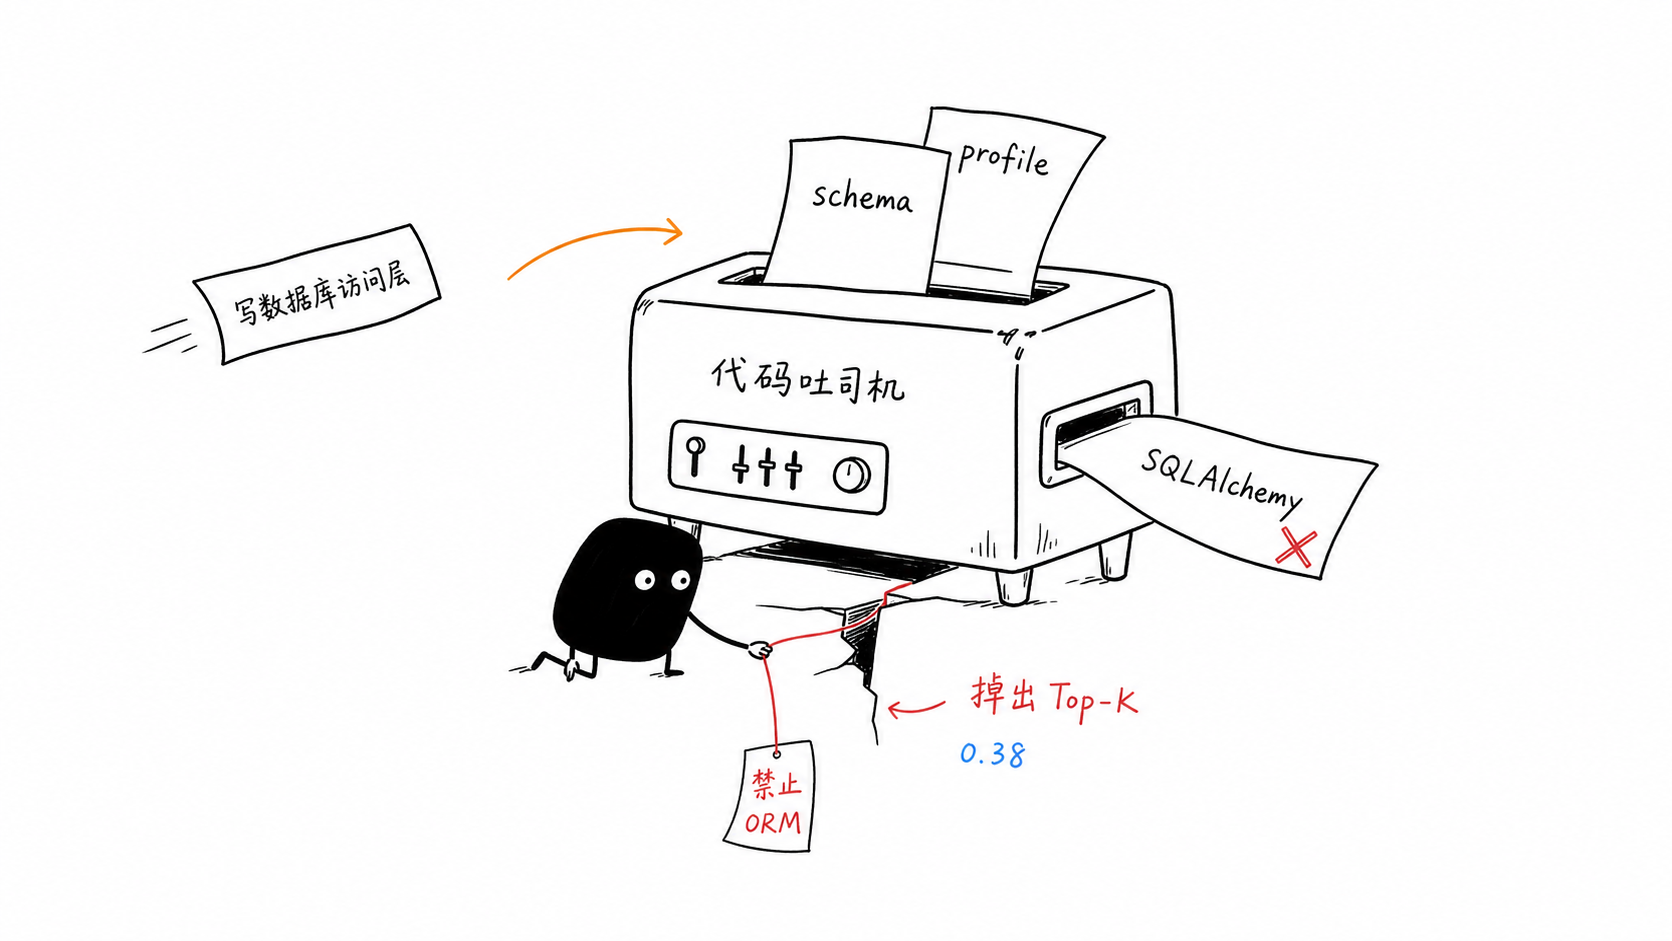
那条保命的红线,就这样悄无声息地被概率淹没了。
0.38 这个数,到底是怎么算出来的
要真正理解为什么 0.38 是个要命的数字,得把向量相似度的计算过程拆开看。
向量检索的第一步,是把文本变成向量。embedding 模型读入一句话,输出一个高维向量(比如 1536 维)。这个向量编码的是这句话里所有词的语义信号的叠加。
公开
同步至部落
取消
完成
0/2000
 荧光笔
 直线
 曲线
笔记
复制
AI
- 深入了解
- 翻译
- 解释
- 总结
仅可试看部分内容,如需阅读全部内容,请付费购买文章所属专栏
《生产级 Agent 排雷实战》,新⼈⾸单¥59
《生产级 Agent 排雷实战》,新⼈⾸单¥59
立即购买
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。

登录 后留言
精选留言
由作者筛选后的优质留言将会公开显示,欢迎踊跃留言。
收起评论