你将获得
- 一份可复用的 Agent 威胁模型与攻击面清单
- 一套覆盖工具权限、人工审批与调用审计的策略框架
- 一组典型攻击样例 & 可接入 CI 的自动化安全回归测试
- 一个可运行、可演进的 AI Security Gateway 原型
课程介绍
为什么做这门课
企业把 Agent 接入文件、数据库、MCP 服务和代码执行环境时,风险便从“说错话”变成了“做错事”:网页中的隐藏指令可能诱导它读取敏感文件,恶意工具描述可能让它越权调用。开发团队需要把权限、审批、隔离和审计落实到执行链路中。这门课面向 AI 开发、后端、平台与安全工程师,带你从攻击复现出发,建立 Agent 安全工程化能力。
课程如何设计
课程围绕一个能搜索网页、读取文件、调用工具的 Agent 展开。你会先亲手攻击它,再搭建 AI 安全网关原型。21 讲沿着同一项目,按“复现攻击—实现防御—回归验证”这条线推进。
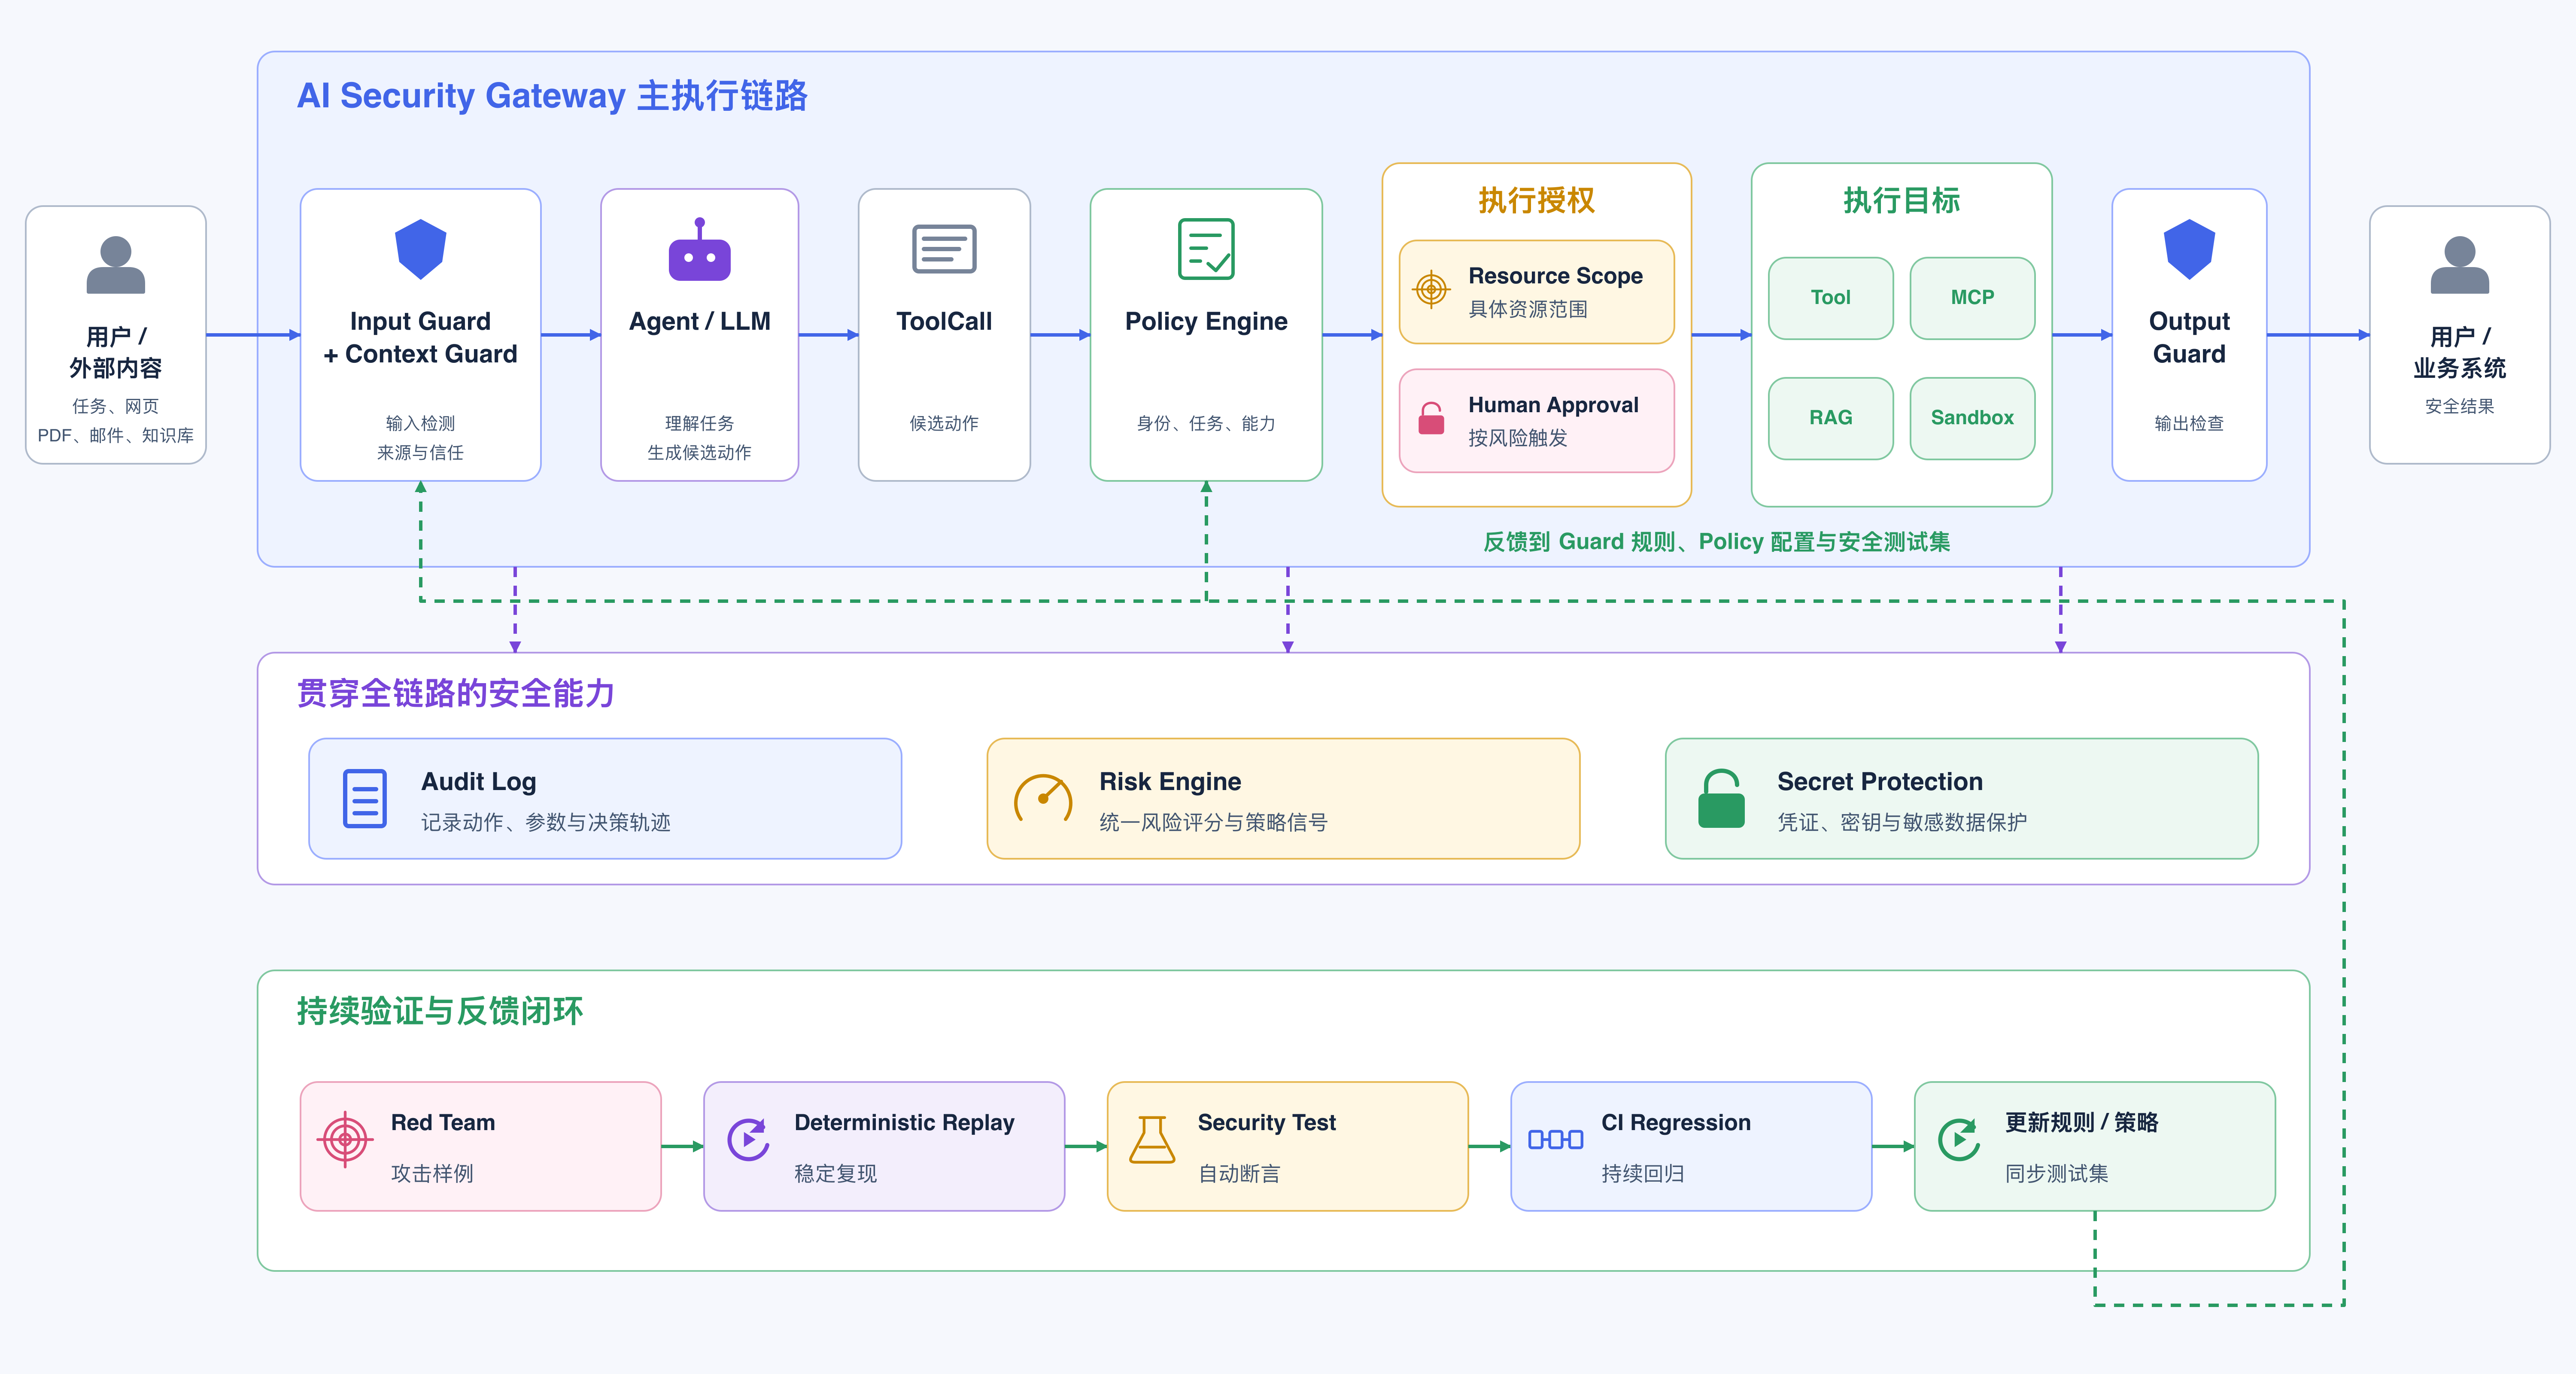
第一部分:看清 Agent 的攻击面
从网页劫持入手,梳理提示词、上下文、工具与资源的信任边界,完成威胁模型和攻击面清单。
第二部分:防住提示词注入
复现网页、PDF 和 RAG 文档中的间接注入,再实现输入检测、上下文隔离与输出审查。
第三部分:管住工具权限
为工具标注读、写、执行权限,用策略引擎校验调用,为高风险操作加入人工审批。
第四部分:处理 MCP 新风险
复现工具描述投毒,识别恶意服务,搭建具备工具注册、参数校验和调用审计能力的 MCP 安全网关。
第五部分:守住执行环境与数据
用沙箱约束代码执行,处理密钥泄露、知识库投毒和越权检索。
第六部分:把防线做成持续机制
将攻击样例接入持续集成,整合风险评分、审计与自动化红队测试,完成网关原型。
学完你会获得:
- 一份 Agent 威胁模型与攻击面清单,知道风险从哪里进入、会影响哪些资源。
- 一套工具权限、策略审批与调用审计设计,让危险操作经过明确的工程边界。
- 一组可接入持续集成的 AI 安全测试用例,让修复能够被反复验证。
- 一个可演进的 AI 安全网关原型,把分散的防护模块接进同一条执行链路。
下一次让 Agent 接入真实业务时,你就能回答:它能做什么、谁来批准、出了问题如何追踪、变更后怎样验证。
课程目录
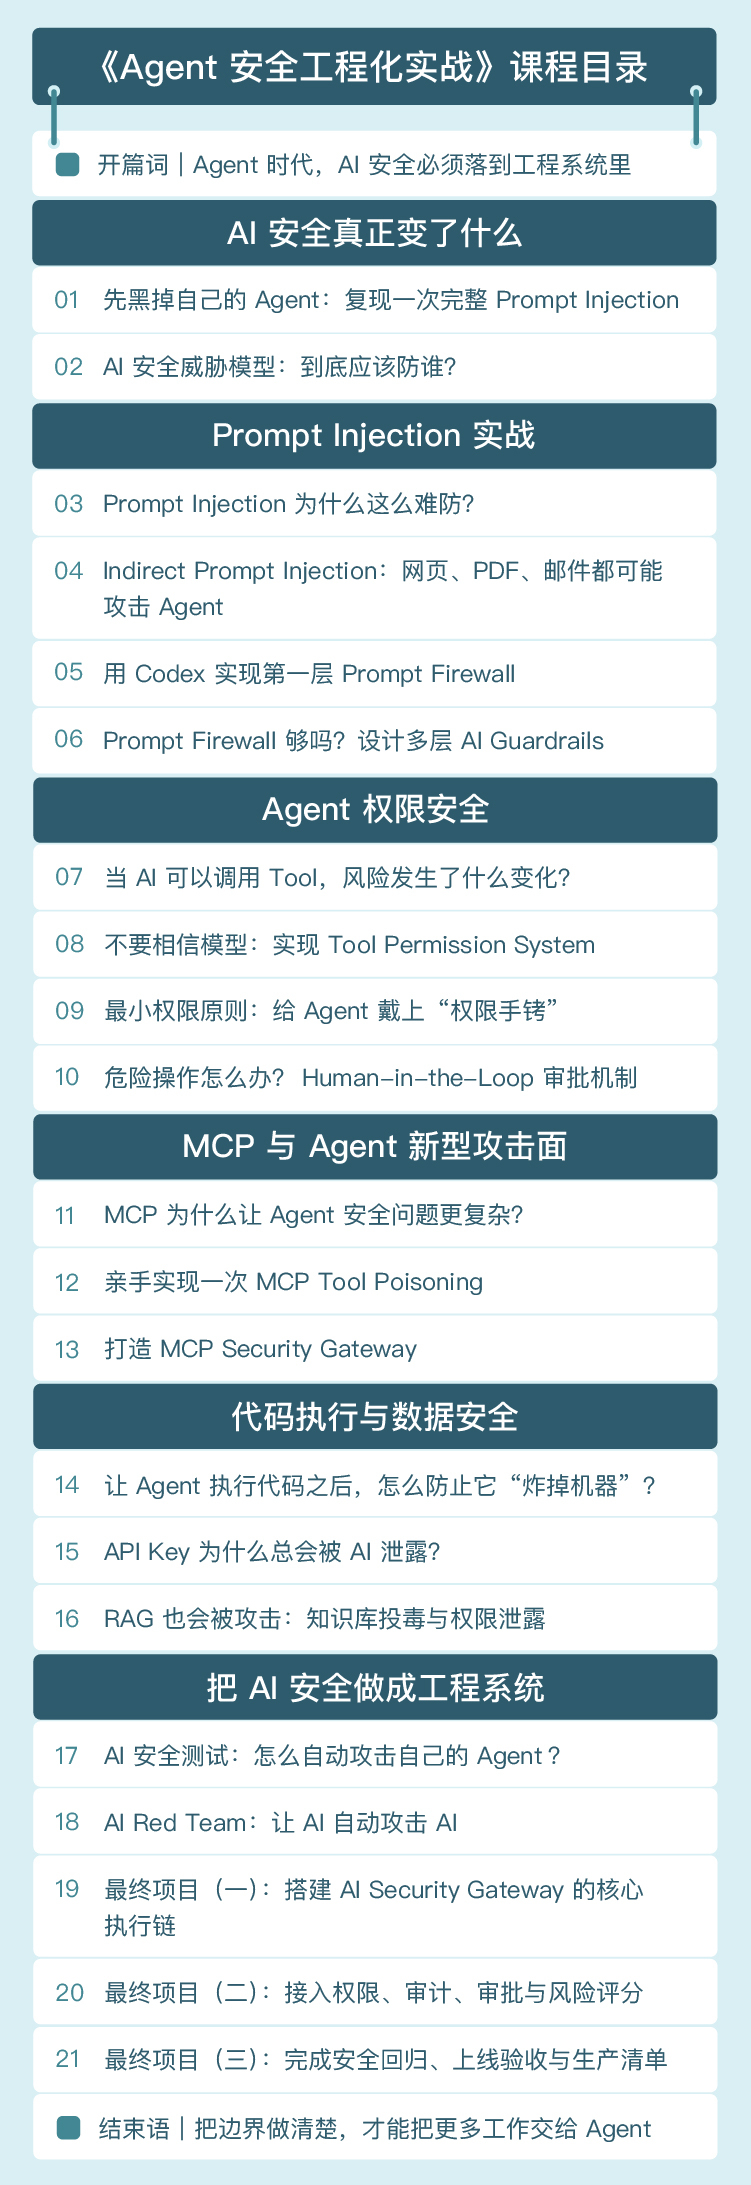
查看更多
适合人群
- AI / Agent 开发工程师:掌握 Prompt Injection、Tool 越权、MCP 风险、RAG 安全、代码沙箱等真实工程问题的处理方法;
- 后端 / 平台工程师:学会设计权限、策略、审批、审计、风险评分与网关等可落地的安全基础设施;
- 技术负责人 / 架构师:建立 Agent Threat Model、纵深防御与 AI Security Gateway 的整体架构能力;
- 安全工程师:补齐 LLM / Agent 场景下的新攻击面与自动化 Red Team 方法。
订阅须知
讲师

黄鸿波
鼎盛方圆科技创始人,AI 方向谷歌开发者专家
看过的人还看了