03 | HTTP世界全览(上):与HTTP相关的各种概念
2019-06-03 Chrono
《透视 HTTP 协议》
课程介绍
讲述:Chrono
时长:大小12.34M
在上一讲的末尾,我画了一张图,里面是与 HTTP 关联的各种技术和知识点,也可以说是这个专栏的总索引,不知道你有没有认真看过呢?
那张图左边的部分是与 HTTP 有关系的各种协议,比较偏向于理论;而右边的部分是与 HTTP 有关系的各种应用技术,偏向于实际应用。
我希望借助这张图帮你澄清与 HTTP 相关的各种概念和角色,让你在实际工作中清楚它们在链路中的位置和作用,知道发起一个 HTTP 请求会有哪些角色参与,会如何影响请求的处理,做到“手中有粮,心中不慌”。
因为那张图比较大,所以我会把左右两部分拆开来分别讲,今天先讲右边的部分,也就是与 HTTP 相关的各种应用,着重介绍互联网、浏览器、Web 服务器等常见且重要的概念。
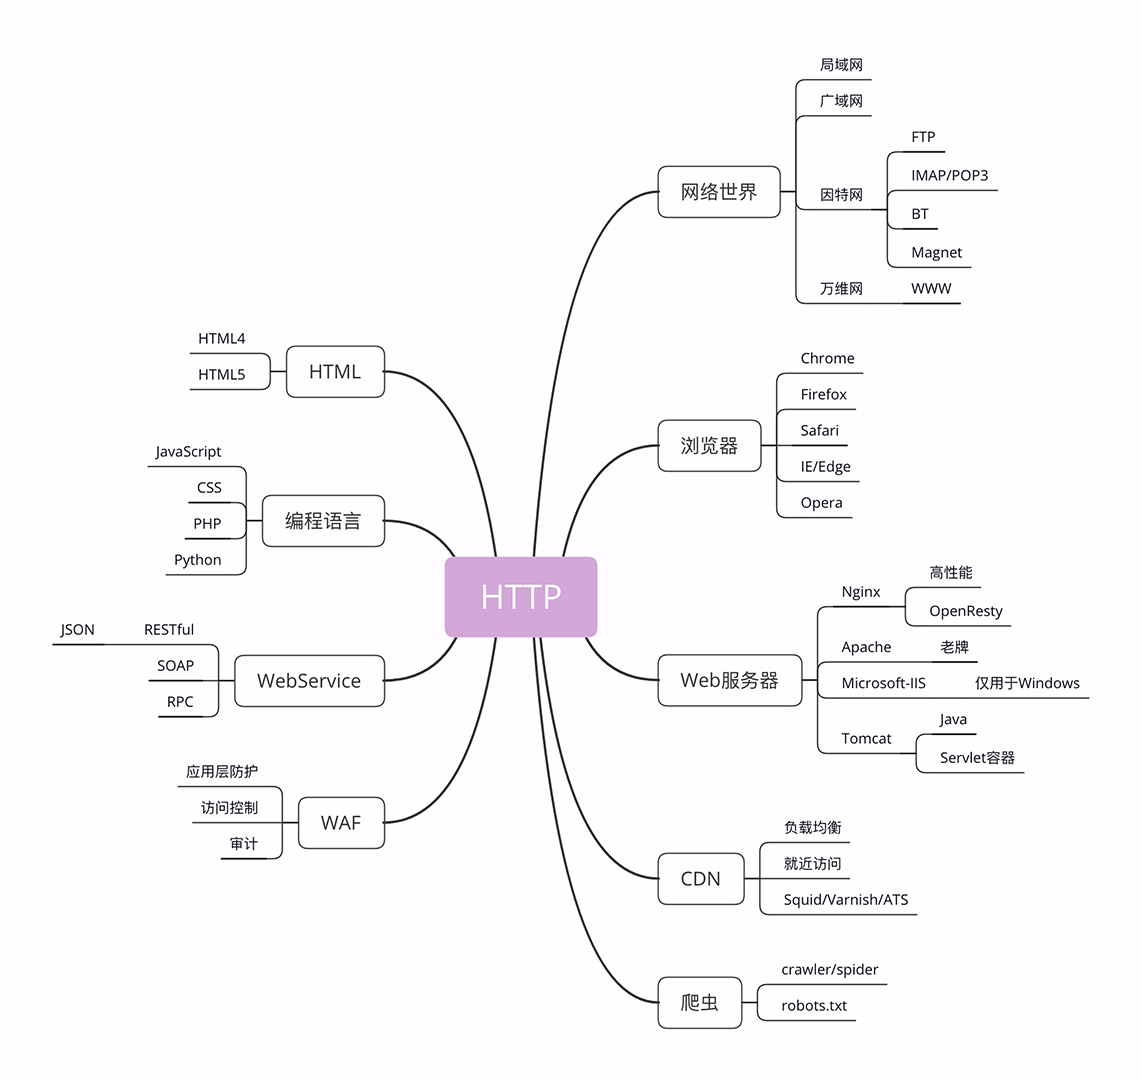
为了方便你查看,我又把这部分重新画了一下,比那张大图小了一些,更容易地阅读,你可...
© 版权归极客邦科技所有,未经许可不得传播售卖。 页面已增加防盗追踪,如有侵权极客邦将依法追究其法律责任。
精选留言
 蚂蚁内推+v2019-06-051. CDN 应当是不区分的,因为爬虫本身也是对 Web 资源的访问,且对于爬虫识别并不是 100% 准确的,因此 CDN 只会去计算实际使用了多少资源而不管其中多少来自爬虫; 2. 个人理解,Web Service 是网络服务实体,而 Web Server 是网络服务器,后者的存在是为了承载前者。
作者回复: √
79 Amark2019-06-03老师,能不能通俗地讲讲RPC, SOAP, restful,之间的区别
作者回复: 这个话题比较大。rpc就是把网络通信封装成了函数调用的形式,所以叫rpc。soap是web service的消息格式。RESTful是一种web服务接口的设计理念。 这三章都是与应用服务有关,但领域不同。
共 3 条评论35 飒~2019-06-12老师 ,暗网是如何规避搜索引擎的爬虫的,它又是怎么被人访问的呢
作者回复: 这个问题比较高端,有其他知道的同学吗?
共 6 条评论30 Vickey Cheung2019-09-09老师,web服务器和web容器区别是什么呢?
作者回复: web服务器主要提供静态资源,而web容器可以运行Java、php等程序提供动态服务。
24 钱2020-03-23首先,非常喜欢这种评论多,互动多的专栏,好像买一赠一,感觉赚啦!有时有些疑惑看完评论就想明白了,这也是我判断一个专栏优质与否的标准之一,老师的专栏很棒,点赞! 1:你觉得 CDN 在对待浏览器和爬虫时会有差异吗?为什么? 刚开始觉得应该有区分的,不然反爬虫技术是干什么吃的,后来想想如果不用反爬虫技术的话应该是没差异的,因为CDN的核心工作是把网络的静态资源放的离用户更近一些,加速网络信息的获取速度,那区分是人要的信息还是机器人要的信息意义也不大,关键是我觉得爬虫如果做的好模仿真人来获取信息,那CND也是很难区分的,再者静态资源本来也是公开透明让用户代理来访问的嘛! 2:你怎么理解 WebService 与 Web Server 这两个非常相似的词? 首先,Web Server比较容易理解,就是web服务器,有软的也有硬的,软的特指有程序代码实现,硬的特指有实实在在的硬件机器组成,比如:Apache、nginx、tomcat、jetty等。 web service 直译是web服务,不过这么讲还是比较抽象不知道她是什么玩意?只好找一下,她的定义了。 Web Service 是一种由 W3C 定义的应用服务开发规范,使用 client-server 主从架构,通常使用 WSDL 定义服务接口,使用 HTTP 协议传输 XML 或 SOAP 消息,也就是说,它是一个基于 Web(HTTP)的服务架构技术,既可以运行在内网,也可以在适当保护后运行在外网。 OK,直白来说,web service 是一种开发规范,规范即约定稍微有些强制执行的意味。她和 web Server 完全不是一种类型的东西,她比较虚是一个组织对某些行为的约束,告诉特定的人群,啥事能做?啥事不能做?啥事应该咋做?展开
作者回复: 回答的非常好,态度认真。 1.感谢支持。 2.区分爬虫这个,完全在于cdn想不想做,因为cdn本质上也是web服务器,如果它认为爬虫影响了服务,就可以反爬虫。如果它决定爬虫也算源站的正常流量,就不反。所以这个问题就是让大家去思考,没有绝对正确的答案。 3.说的很清楚,有自己的思考就是好事。。
20 redrain2019-06-03有些网站全新上线的,没有外链,也没特意提交过,为什么也会有爬虫经过呢,入口在哪里
作者回复: 这可能是从dns域名服务商那里获取了你的网站。
18 lfn2019-06-04不是很理解web server和web service的区别。难道我们的服务不用nginx就不能用了么?我自己写个tcp server, 根据用户请求调用特定的handler返回数据,那我自己就是个server啊,也是service.老师能不能更清晰地定义下server.习惯了tcp编程的概念,这里的server就显得怪怪的,给人一种router的感觉.
作者回复: 这里首先要理解web,web就是指的http。web server就是提供http服务的server、web service就是运行在http协议上的服务接口规范。 自己写的是tcp server,就不是web server。 service通常是指服务程序,跑在server上,server可以理解成容器、平台。
15 耿斌2019-06-061. CDN可以根据User-Agent来判断发起请求的一端是浏览器还是爬虫,对待爬虫可以特殊处理返回特定内容 2. WebService是基于Web(HTTP)的服务器架构技术,基于HTTP协议传输xml或soap数据。WebServer分硬件和软件,硬件指服务器、云之类,软件如Nginx、Apache等
作者回复: √
共 4 条评论13 永钱2019-06-03老师把tomcat放在web服务器中比较,说速度慢,不公平呀
作者回复: 抱歉啦,的确,tomcat应该是web容器。
10 刘志兵2019-08-02老师,服务器只有这么少的几个吗,有一些grpc 服务算服务器吗,finagle, grpc等,还有spring不是也可以提供服务吗
作者回复: 里面说的特指的是“Web服务器”,也就是说专门提供http服务的服务器软件。 其他的像tomcat、netty等虽然也有http服务,但不是专门做这个的,http只是“副业”,功能远不如专业的Apache、Nginx强大。 grpc属于服务开发框架,用的是基于http/2的grpc协议。
8